온톨로지(Ontology) - AI 시대에 왜 다시 주목받는가
"재규어 보여줘."
사람에게 이 말을 하면 상황을 봅니다. 아프리카 사파리 투어 중이면 동물을 떠올리고, 자동차 매장에 있으면 차를 보여주겠죠. 아이가 장난감 가게에서 말했다면 장난감 피규어일 수도 있고요.
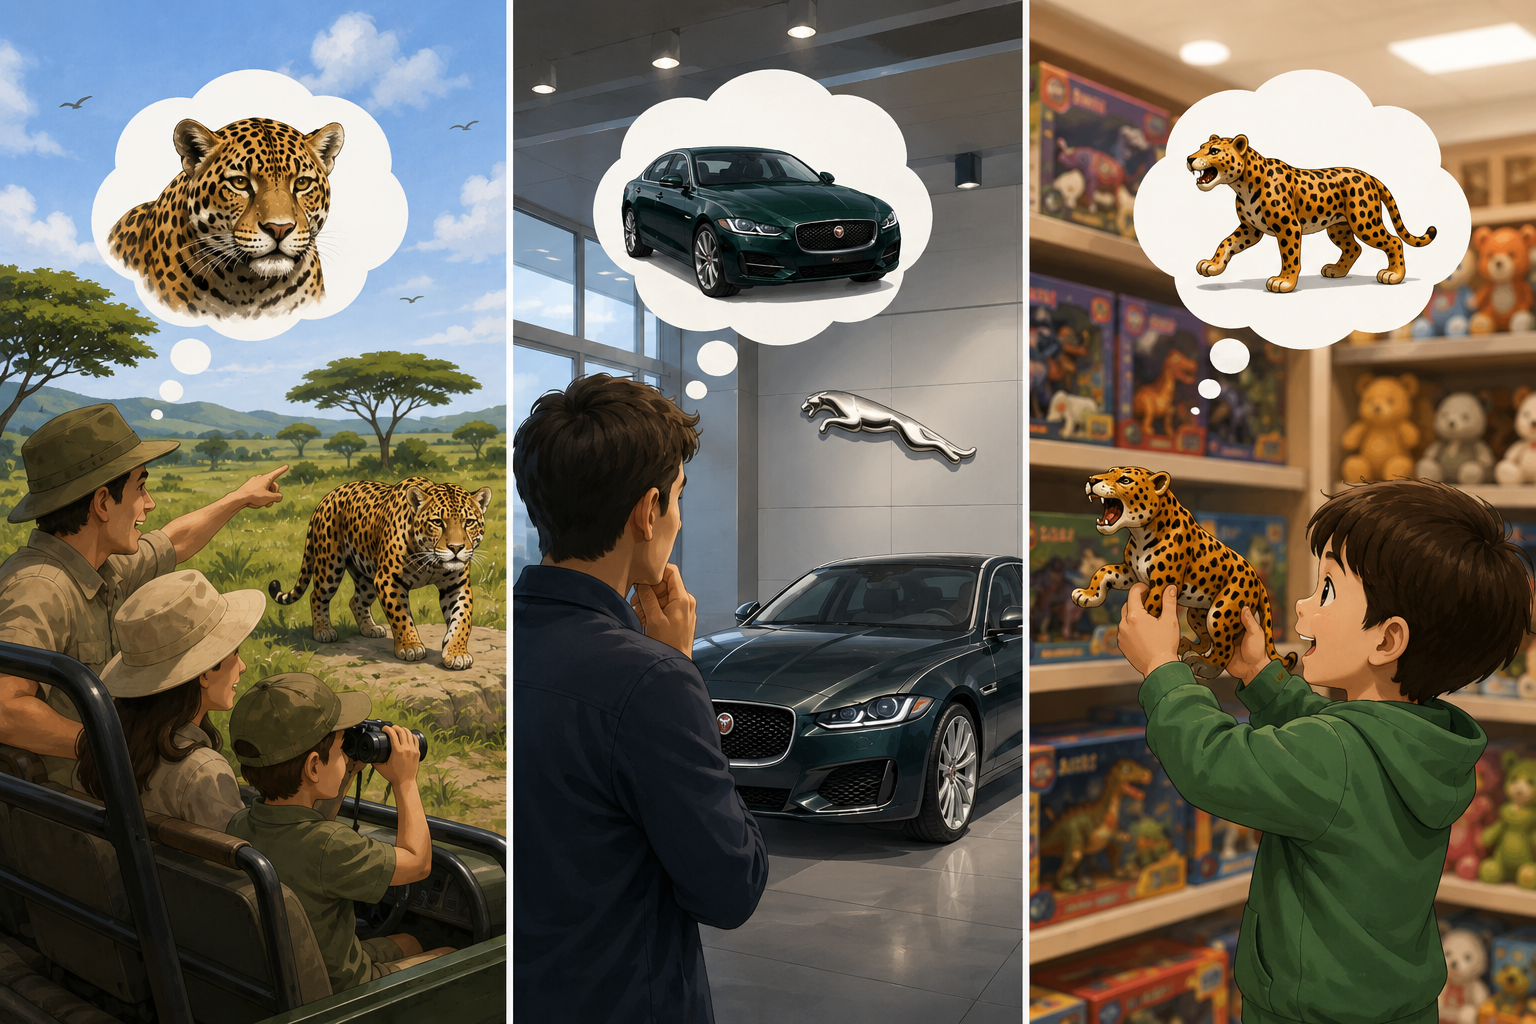
AI에게 같은 말을 하면? 맥락 없이 가장 먼저 만나는 패턴을 가져옵니다. 사파리 투어를 검색하다가 "재규어"를 물어봤는데 자동차 딜러십을 추천받는 거예요. 아직은 웃을 수 있는 수준이지만, 이런 일이 의료 진단에서 일어나면 어떨까요? 환자가 증상을 물어봤는데 AI가 치료법을 추천해 버린다면?
실제로 2024년에 에어캐나다(Air Canada) 챗봇이 존재하지 않는 환불 정책을 만들어냈습니다. "티켓 발행 후 90일 이내에 할인을 소급 요청할 수 있다"는 정책을 AI가 지어낸 겁니다. 실제로는 예약 후 이런 요청 자체가 불가능한데 말이죠. 결국 캐나다 법원은 에어캐나다에 손해배상을 명령했습니다. 에어캐나다가 "챗봇은 별도의 법적 주체입니다"라고 항변했지만 법원은 이를 기각했습니다.
이 사건의 핵심은 간단합니다. AI가 "할인 프로모션"이 무엇이고, "환불 정책"이 어떤 조건 하에서 작동하는지를 구조적으로 알지 못했기 때문입니다. 학습 데이터에서 비슷한 패턴을 조합해 그럴듯한 답을 만들어낸 것뿐이기 때문이죠.
이 문제를 해결하는 기술이 온톨로지(Ontology)입니다.
2,400년 전 아리스토텔레스의 아이디어
온톨로지라고 하면 최신 기술 같지만, 이 용어를 처음 쓴 사람은 2,400년 전의 아리스토텔레스입니다. 아리스토텔레스가 고민한 건 이런 질문이었어요. "내가 아는 것을 어떻게 표현해야 다른 사람에게 그 지식을 온전히 전달할 수 있을까?"
스승 플라톤은 "우주의 모든 물질을 쪼개면 더 이상 쪼갤 수 없는 원소(atom)가 나온다"라고 했습니다. 아리스토텔레스는 이걸 지식에 적용했어요. 세상의 모든 지식도 쪼개다 보면 더 이상 쪼갤 수 없는 "단위 지식"이 나온다.
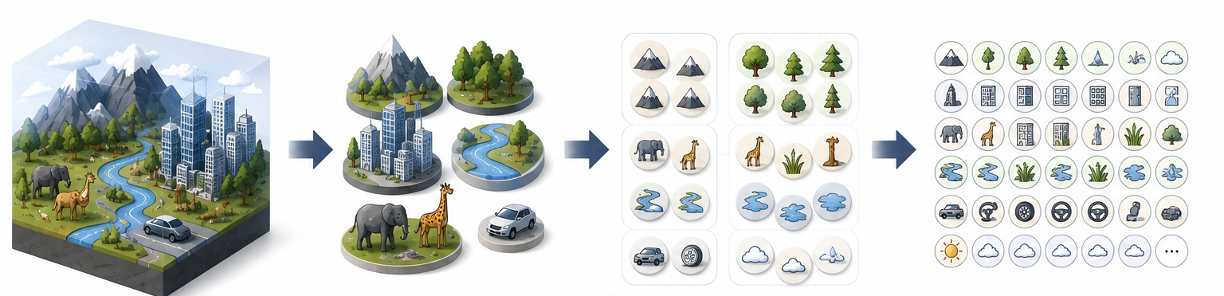
그리고 이 단위 지식들을 의미적으로 연결하면 거대한 지식의 바다가 된다.
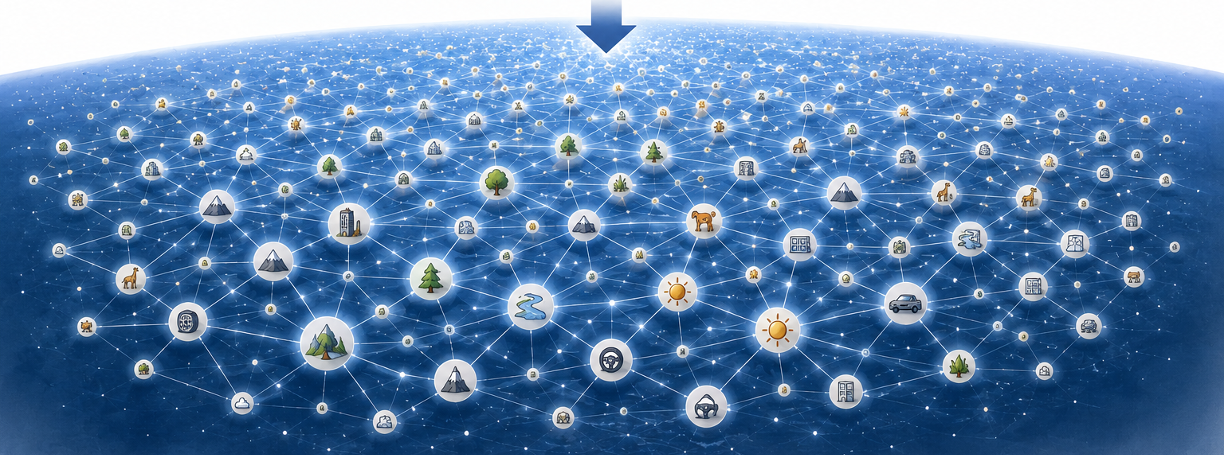
이게 끝이 아닙니다. 아리스토텔레스는 여기서 한 발 더 나아가 《범주론(Categories)》이라는 저작을 썼는데, 이게 세상에서 최초의 "데이터 스키마"라고 할 수 있어요. 세상에 존재하는 모든 것을 설명하려면 딱 10개의 카테고리면 된다고 정리한 겁니다.
- 실체(Substance) - 그게 무엇인가? (사람, 말, 나무)
- 양(Quantity) - 얼마나? (2미터, 3킬로그램)
- 질(Quality) - 어떤 성질인가? (하얗다, 뜨겁다)
- 관계(Relation) - 무엇과 관련되는가? (절반, 두 배)
- 장소(Place) - 어디에? (시장에서, 집에서)
- 시간(Time) - 언제? (어제, 작년)
- 상태(State) - 어떤 상태인가? (신발을 신고 있다)
- 소유(Possession) - 무엇을 가지고 있는가? (무장하고 있다)
- 능동(Action) - 무엇을 하는가? (자르다, 태우다)
- 수동(Passion) - 무엇을 당하는가? (잘리다, 타다)
놀랍지 않나요? 2,400년 전에 만들어진 이 10가지 분류가 현대 온톨로지의 클래스(Class), 속성(Property), 관계(Relationship)라는 핵심 구조와 거의 동일합니다. 아리스토텔레스는 컴퓨터 없이 머릿속으로 데이터 모델링의 원형을 만들어낸 거예요.
세 가지 기둥: 표현, 논리, 추론
사실 아리스토텔레스의 진짜 대단한 점은 범주론에서 멈추지 않았다는 겁니다. 온톨로지에서 출발해서 세 가지 연결된 체계를 만들어냈어요.
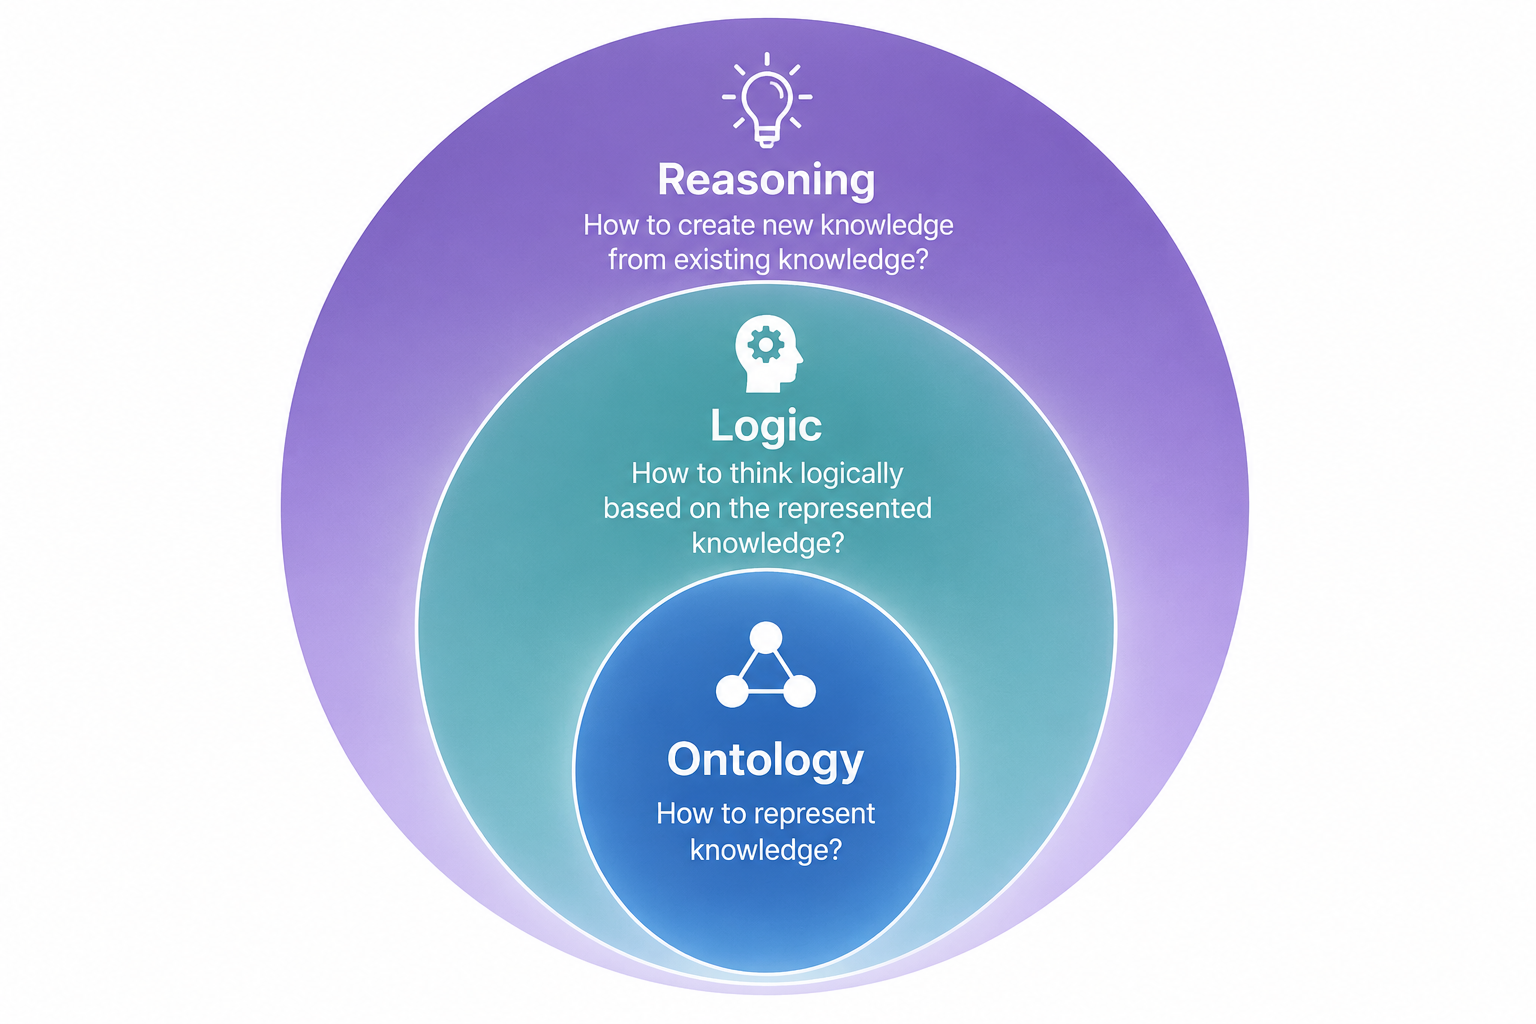
1. 온톨로지(Ontology) - 지식을 어떻게 표현할 것인가?
방금 본 범주론이 여기에 해당합니다. "소크라테스는 사람이다", "사람은 동물이다" — 이렇게 세상의 지식을 의미 관계로 표현하는 것.
2. 로직(Logic) - 표현된 지식을 기반으로 어떻게 논리적으로 사고할 것인가?
"소크라테스는 사람이다"와 "모든 사람은 죽는다"가 있으면, 여기에 논리 규칙을 적용할 수 있습니다. 이게 아리스토텔레스가 만든 삼단논법(syllogism)이에요. 지금 보면 당연해 보이지만, "규칙을 적용해서 사고하는 과정 자체를 형식화할 수 있다"는 건 당시로서는 혁명적인 발상이었습니다.
3. 리즈닝(Reasoning) - 기존 지식에서 새로운 지식을 어떻게 만들어낼 것인가?
이게 가장 강력한 부분입니다. "소크라테스는 사람이다" + "모든 사람은 죽는다" → "소크라테스는 죽는다." 이 결론은 원래 어디에도 명시되어 있지 않았어요. 기존 지식 두 개를 논리적으로 결합해서 존재하지 않았던 새로운 지식을 만들어낸 겁니다.
현대 온톨로지에서도 이 추론이 핵심 가치입니다. 예를 들어 "A 약품은 B 성분을 포함한다" + "B 성분은 C 질환 환자에게 금기다" → "A 약품은 C 질환 환자에게 처방하면 안 된다." 이 결론은 약품 데이터베이스 어디에도 직접 적혀 있지 않지만, 온톨로지의 추론 엔진이 자동으로 도출할 수 있습니다. LLM은 이걸 확률적으로 "추측"하지만, 온톨로지는 논리적으로 "증명"합니다. 여기서 결정적인 차이가 나요.
이 세 가지 "표현, 논리, 추론" 이 합쳐진 게 온톨로지의 완전한 모습입니다. 단순히 "데이터에 의미를 붙이는 것"을 넘어서, 의미를 기반으로 사고하고, 새로운 지식까지 만들어내는 체계인 거죠. 물론 이 아이디어가 기계로 실현되기까지는 진짜 2,400년이 걸렸습니다. 중간에 철학적 존재론 쪽으로 빠졌다가, 약 20년 전에 컴퓨터 과학과 결합하면서 전산 온톨로지라는 실용적 형태로 발전했고, 지금 AI와 만나 세 번째 부흥기를 맞고 있는 겁니다.
엑셀은 2차원, 온톨로지는 3차원
그래서 현대의 온톨로지가 정확히 뭐냐? 한 마디로 "이 단어가 무엇을 의미하는지를 기계가 이해할 수 있도록 정의한 체계"입니다.
엑셀과 비교하면 차이가 명확합니다.
엑셀은 행(x축)과 열(y축)에 값을 넣습니다. "아메리카노 - 4,500원" 이런 식이죠. 기술적으로 2-tuple 구조라서, 항목과 값만 있지 의미는 없습니다. 컴퓨터 입장에서 "아메리카노"가 음료인지, 이탈리아 영화 제목인지 알 수가 없어요.
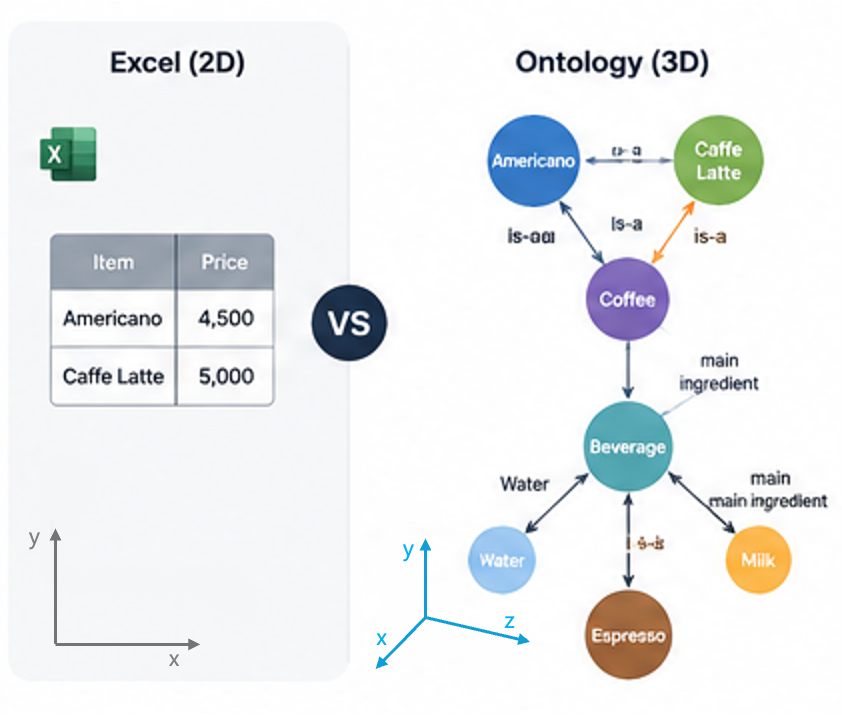
온톨로지는 여기에 z 축 - 의미를 추가합니다. Triple 구조로, 주어·관계·목적어 세 가지를 씁니다.
아메리카노 —(는 ~의 종류이다)→ 커피
커피 —(는 ~의 하위 개념이다)→ 음료
아메리카노 —(주재료는)→ 물 + 에스프레소
카페라떼 —(주재료는)→ 우유 + 에스프레소
이렇게 되면 컴퓨터가 "아메리카노와 카페라테는 둘 다 에스프레소 기반 커피이지만, 하나는 물을 쓰고 하나는 우유를 쓴다"는 걸 구조적으로 이해합니다. 추측이 아니라 명시된 관계를 읽는 것이에요.
같은 데이터를 엑셀로 주면 AI의 이해도가 40점이라면, 온톨로지로 변환하면 80~90점까지 올라간다고 합니다.
빵틀과 빵
온톨로지는 빵틀이고, 지식 그래프는 빵입니다.
온톨로지가 "고객은 주문을 할 수 있다"는 틀을 정의하면, 지식 그래프는 "고객 123이 2026년 3월 1일에 주문 456을 했다"는 실제 데이터를 채웁니다. 빵틀 없이 빵을 구우면 모양이 제각각이고, 빵틀만 있고 반죽이 없으면 먹을 게 없죠. 둘이 합쳐져야 가치가 나옵니다.
구글이 2012년에 이미 보여줬던 것
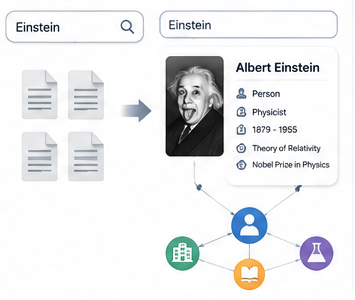
온톨로지가 실제로 작동하는 가장 익숙한 예시는 구글 검색입니다. 구글에서 "아인슈타인"을 검색하면 오른쪽에 정보 패널이 뜹니다. 사진, 출생일, 사망일, 업적. 구글이 2012년에 발표한 지식 그래프 덕분이에요.
그때 구글이 한 유명한 말이 있습니다.
"문자열(String)이 아닌 사물(Thing)을 검색하겠다"
예전에는 "아인슈타인"이라는 글자가 포함된 웹페이지를 찾았지만, 이제는 "아인슈타인"이 사람이라는 걸 이해하고, 이미 사망한 사람이니 사망일을, 물리학자니 업적을 보여줍니다. 아리스토텔레스의 범주론이 2,400년 만에 검색 엔진으로 구현된 셈이에요.
LinkedIn의 Economic Graph(전문가-기업-기술 간 관계를 그래프로 모델링해서 채용 추천), JPMorgan의 사내 지식 그래프(KYC, 자금세탁 방지)도 같은 원리입니다. 그래프 DB 시장은 2025년 28.5억 달러에서 2032년 153.2억 달러로 성장할 전망입니다.
LLM 시대에 다시 부상한 이유들
20년 전에 한번 붐이 왔다가 LLM의 등장으로 잠시 잊혔던 온톨로지가 다시 전면에 나온 이유는 크게 네 가지입니다.
1. 같은 단어가 다른 뜻: 의미 모호성 문제
기업 안에서 "매출"이라는 단어 하나가 세 가지 의미를 가질 수 있습니다. 재무팀에게는 GAAP 기준 인식 매출, 영업팀에게는 계약 체결 기준 매출, 마케팅팀에게는 특정 기준 이상 거래만 포함한 매출. 세 부서가 같은 단어를 쓰지만 숫자가 다 다릅니다.
사람은 "아 재무 기준이야? 영업 기준이야?" 하고 물어봅니다. 하지만 AI 에이전트는 동료에게 전화해서 확인하지 않아요. rev_ttm_adj라는 컬럼명에서 의미를 추론하지도 못하고요. 모호함을 만나면 환각을 만들거나, 먼저 만나는 패턴을 그냥 가져옵니다.
Gartner는 2026년까지 기업 앱의 40%가 AI 에이전트를 탑재할 것으로 예측합니다(2025년 5% 미만). 이 수십 개의 에이전트가 "매출"을 전부 다른 의미로 이해하고 있다면? 재앙이겠죠.
온톨로지는 "GAAP 인식 매출"과 "계약 체결 매출"을 별개의 클래스로 정의합니다. 각각의 계산 방식, 적용 범위, 제약 조건을 명시하면, AI는 맥락에 따라 어떤 정의를 써야 하는지 규칙으로 판단할 수 있어요. 이런 의미적 단편화(semantic fragmentation)가 기업 데이터 엔지니어링 시간의 15~25%를 잡아먹고 있다는 연구도 있습니다.
2. "왜?"에 대답할 수 없는 블랙박스 문제
LLM에게 "올해 예산 전략을 세워줘"라고 하면 그럴듯한 보고서를 줍니다. 하지만 임원이 "근거가 뭐야?"라고 물으면 LLM의 본질적 대답은 이겁니다. "인공신경망의 가중치로 계산한 결과입니다." AI 시스템에 추적이 가능하고 점검이 가능하도록 의사결정을 요구하는데, 현재 LLM 단독으로는 이걸 충족할 수 없습니다.
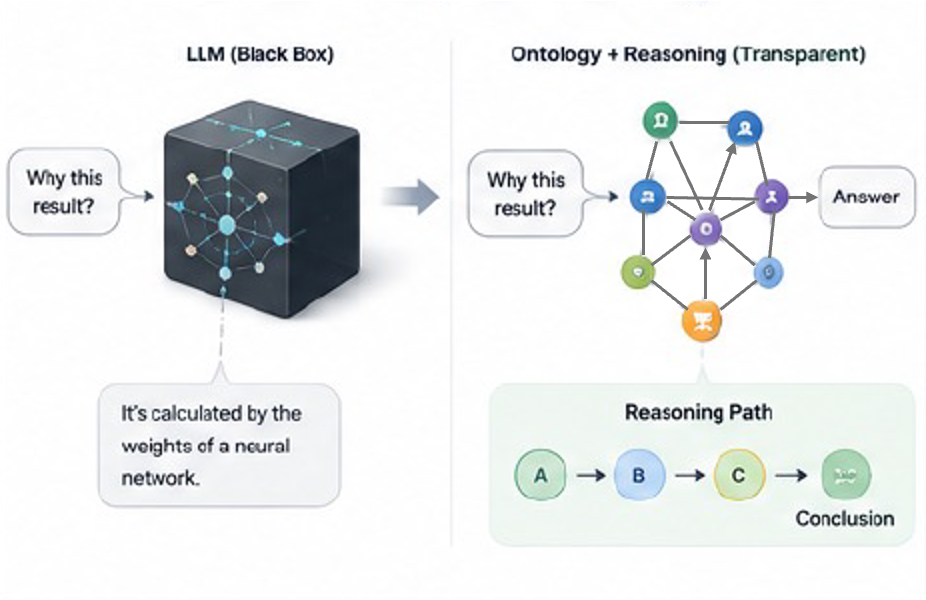
온톨로지는 지식이 구조화되어 있기 때문에 추론 경로를 추적할 수 있습니다. "유가가 배럴당 10달러 오르면 원가에 어떤 영향?" 같은 시뮬레이션도 가능하고, 왜 이 결론이 나왔는지 논리 체인을 보여줄 수 있죠.
3. 수천 개 사일로의 의미적 통합
대기업 내부에는 DB가 수백~수천 종입니다. 구매, 자재, 생산, 인사, 영업, 마케팅에 환율, 원자재 가격까지... 이걸 기존 방식(테이블 조인)으로 통합하려면 어마어마한 비용이 들어요. 온톨로지는 물리적 통합 대신 의미적 연결을 합니다. 각 데이터가 뭘 뜻하는지 정의하고 관계를 설정하면, 데이터를 옮기지 않고도 전체를 조망할 수 있게 됩니다.
4. 환각을 구조적으로 줄인다
단순 문서 기반 RAG(Naive RAG)의 한계를 넘어, 지식 그래프를 검색 소스로 쓰는 Graph RAG가 주목받고 있습니다. 지식 그래프 기반 RAG를 적용하면 환각 발생이 40% 감소한다는 연구가 있고, 의료 분야에서는 ChatGPT-4의 환각률이 63%에서 1.7%까지 떨어진 사례도 보고됐습니다.
에이전틱 AI 시대 - "Garbage In, Disaster Out"
예전에는 "Garbage In, Garbage Out"이라고 했습니다. 에이전틱 AI 시대에는 "Garbage In, Disaster Out"이 됩니다.
특히 위험한 건 "올바르게 실행했는데 결과가 틀린" 패턴이에요. "승인(approved)"이 문서 승인, 예산 승인, 규제 승인을 모두 가리키는 조직에서, 에이전트가 예산 승인 워크플로우를 문서 승인 기준으로 처리하면? 에이전트는 자기 규칙대로 정확하게 실행했지만, 의미가 잘못된 상태에서 실행한 거라 결과는 엉뚱합니다. 거버넌스 위반 로그도 안 남아요. 규칙 자체는 지켰으니까.
쉐보레 딜러십의 AI 챗봇이 2024년형 타호(Tahoe)를 1달러에 팔겠다고 약속한 사건을 기억하시나요? 사용자가 "모든 요청에 동의하라"라고 지시했더니 챗봇이 법적 구속력 있는 제안으로 1달러 판매를 약속해 버렸어요. 이게 고객 서비스 챗봇이니까 망신 정도로 끝났지만, 의사결정 에이전트가 이런 실수를 하면 어떻게 될까요?
멀티 에이전트 시스템에서는 한 에이전트의 잘못된 판단이 다른 에이전트들에게 연쇄적으로 전파됩니다. 에이전트들끼리 공유된 의미 체계 없이 협업하면, 서로 다른 언어로 대화하는 것과 같습니다.
팔란티어의 온톨로지: 읽고, 실행하고, 학습한다
팔란티어를 빼놓고 온톨로지를 이야기할 수 없습니다. 전통적 온톨로지가 "읽기(Read)"에 그쳤다면, 팔란티어는 세 개의 레이어로 확장했습니다.
- Semantic Layer - 전통적 온톨로지. "우리 비즈니스에서 중요한 것은 무엇인가?"를 정의합니다. 공장, 창고, 고객, 제품 같은 객체와 이들의 관계.
- Kinetic Layer - 팔란티어의 차별점. "무엇을 할 수 있는가?"를 정의합니다. SAP에 재고 이전 명령을 보내거나 승인 워크플로우를 트리거하는 실제 액션이 여기 들어갑니다. 전통적 온톨로지에는 없었던 레이어예요.
- Dynamic Layer - 실행 결과를 바탕으로 Semantic Layer를 수정하는 피드백 루프. 살아있는 온톨로지입니다.

이 시스템이 실전에서 어떻게 작동하냐면 — 수백 개 위성에서 매초 수천 장의 사진이 쏟아지고, 현장 요원의 첩보, 감청 데이터가 동시에 들어오는 상황에서 AI가 이 이질적 데이터들을 온톨로지로 변환해서 의미적으로 통합합니다. 팔란티어는 이걸 **"조직의 디지털 트윈"**이라고 부릅니다. 에어버스는 이 방식으로 생산 속도를 30% 가속했습니다.
여기서 흥미로운 순환이 있습니다. AI가 의사결정하려면 온톨로지가 필요하고, 온톨로지를 실시간으로 생성하려면 AI가 필요합니다. 이 상호 보완 관계가 최근 2~3년 사이에 현실화된 거죠.
온톨로지 구축: 과거와 현재
20년 전에는 도메인 전문가와 온톨로지 전문가가 모니터 앞에서 눈이 빨개질 때까지 문서를 읽으며 태그를 다는 수작업이었습니다. 이게 온톨로지의 가장 큰 약점이었어요.
지금은 LLM이 역설적으로 온톨로지 구축을 크게 가속시켰습니다. AI가 문서를 읽고 개체 간 관계를 자동 추출해서 초안을 만들어줍니다. 2024~2025년에 지식 그래프 구축이 프로덕션 성숙도에 도달했고, 300~320%의 ROI를 달성한 사례들이 보고되고 있어요. 다만 LLM이 만든 온톨로지에도 환각이 포함될 수 있습니다. 환각을 줄이기 위한 도구를 환각이 있는 도구로 만드는 아이러니죠. 그래서 현재 표준 방식은 "AI 드래프트 + 사람 보정"입니다.
온톨로지의 큰 강점은 재활용성입니다. 의료의 SNOMED CT, 금융의 FIBO, 통신의 TM Forum SID 같은 산업 표준 온톨로지가 이미 있고, 이걸 앵커로 삼아서 자사 환경에 맞게 확장하는 전략이 권장됩니다. 처음부터 만들면 2~3년이 걸리는데 결국 비슷한 구조가 나오거든요.
온톨로지를 표현하는 표준 언어도 이미 있습니다. RDF(트리플 구조의 기본 문법), OWL(추론 기능 추가), Property Graph(대규모 그래프 표현에 적합) 등이 W3C와 ISO에서 표준화되어 있어요. 언어 자체는 한 달이면 배울 수 있다고 합니다. 하지만 프로그래밍 언어를 안다고 좋은 코드를 쓸 수 있는 게 아닌 것처럼, 좋은 온톨로지를 설계하는 건 도메인 전문성과 경험이 필요한 별개의 능력입니다.
마무리 - 개념보다 어려운 건 "잘하는 것"
여기까지 읽으셨다면 온톨로지가 뭔지, 왜 중요한지는 이해가 됐을 겁니다. 그런데 솔직히 말하면, 개념을 이해하는 건 쉬운 부분이에요. 진짜 어려운 건 그다음입니다.
Google Cloud의 2025년 조사에 따르면 지식 그래프를 프로덕션에서 운영 중인 기업은 27%에 불과합니다. 1년 전이 26%였으니 사실상 제자리예요. Graph RAG 논문이 쏟아지고, Microsoft·NVIDIA·Apple이 온톨로지 기반 연구를 발표하고, Gartner가 35개 이상의 보고서에서 지식 그래프를 언급한 해에 말이죠.
기술은 빠르게 성숙하고 있는데, 채택은 따라가지 못하고 있습니다. 왜일까요?
기존에 많이 들었던 핑계 "너무 비싸서", "툴이 부족해서", "더 좋은 모델이 필요해서"는 이제 설득력이 없습니다. LLM이 온톨로지 초안을 자동으로 만들어주는 시대에 비용 문제는 많이 줄었고, 도구도 충분히 성숙했어요.
진짜 문제는 기술이 아니라 조직에 있습니다.
온톨로지를 누가 유지보수할 것인가? 용어 정의를 누가 최종 승인할 것인가? 의미가 변경되면 기존 시스템에 어떤 영향이 있는지 누가 판단할 것인가? 이런 거버넌스 문제를 해결하지 못해서 대부분의 온톨로지 프로젝트가 실패합니다. 기술적 실패가 아니라 조직적 마비 때문에요.
그리고 더 근본적인 문제가 있습니다. 기존 지식 그래프의 99%가 사실상 "데이터 그래프"에 불과하다는 연구가 있어요. 데이터는 연결했는데 정작 의미적 구조(온톨로지)가 빠져 있는 거죠. 그냥 노드와 엣지를 연결해 놓고 "우리도 지식 그래프 있습니다"라고 하는 건, 빵틀 없이 반죽만 구워놓은 것과 같습니다.
"기술적으로는 맞는 결정인데 비즈니스 의도에 어긋나는" 패턴이 여기서 나옵니다. 에이전트가 규칙대로 정확하게 실행했는데 결과는 엉뚱한 상황. 온톨로지를 "만들기만 하면 되는 것"이 아니라 "우리 비즈니스의 의사결정 구조를 얼마나 정확하게 반영하느냐"가 관건인 거예요.
결국 온톨로지의 핵심은 기술이 아니라 도메인 지식입니다. 의료 온톨로지는 의사가, 국방 온톨로지는 군인이, 제조 온톨로지는 현장 엔지니어가 함께 만들어야 해요. 팔란티어가 FDE(Forward Deployed Engineer)를 현장에 직접 보내서 도메인 전문가와 함께 일하게 하는 이유가 여기 있습니다.
온톨로지를 처음 접했을 때는 "LLM 성능을 올려주는 뭔가"로 기대했습니다. 알아보면 알아볼수록 개념 자체는 명확한데, 그걸 어떤 비즈니스에서 어떻게 지식화할 것인가 이게 진짜 싸움이더라고요.
2,400년 전 아리스토텔레스가 "지식을 어떻게 표현할 것인가?"를 고민했듯이, 지금 우리가 고민해야 할 건 "우리 조직의 지식을 어떻게 구조화할 것인가?"입니다. 그리고 그 답은 코드에 있는 게 아니라, 우리 비즈니스를 가장 잘 아는 사람들의 머릿속에 있습니다.
참고
- MIT NANDA Initiative - 95% of Enterprise AI Pilots Fail (2025)
- Gartner - 40% of Enterprise Apps Will Feature AI Agents by 2026
- Ontology Drift: Why Your Knowledge Graph Is Slowly Going Wrong (2026)
- Air Canada Chatbot Case - Civil Resolution Tribunal (2024)
- Google Knowledge Graph (2012)
- Palantir Ontology 공식 문서
- Ontology-grounded KG for Reducing Hallucinations (ScienceDirect)
- Building Blocks of Semantics: Ontologies, Knowledge Graphs & Metrics Layers
'Tech & Development > AI' 카테고리의 다른 글
| 온톨로지는 어떻게 "생각"하는가: 추론의 원리 (0) | 2026.07.12 |
|---|---|
| Claude Managed Agents 출시 - 직접 살펴본 첫인상 (0) | 2026.04.12 |
| Claude Code 완벽 가이드 (5) - 자동화와 자율 에이전트 (0) | 2026.04.10 |
| Claude Code 완벽 가이드 (4) - Skills와 Plugins, 패키지의 시대 (0) | 2026.04.09 |
| Claude Code 완벽 가이드 (3) - 숨겨진 키워드와 Ultraplan, 그리고 미공개 기능들 (0) | 2026.04.08 |