[ OCR ] Chandra OCR - 한글 테스트
밀린 숙제를 하듯 그동안 테스트해보고 싶었던 OCR 도구들을 하나씩 정리하고 있습니다. 이번에는 최근 벤치마크에서 1위를 기록한 Chandra를 테스트해 봤습니다.
Chandra는 Datalab에서 만든 OCR 모델로, 이미지와 PDF를 구조화된 HTML/Markdown/JSON으로 변환합니다. 특히 레이아웃 정보를 보존하면서 변환하는 것이 특징입니다.
GitHub - datalab-to/chandra: OCR model that handles complex tables, forms, handwriting with full layout.
OCR model that handles complex tables, forms, handwriting with full layout. - datalab-to/chandra
github.com
Chandra 주요 특징
Chandra는 Datalab에서 개발한 OCR 모델로, 같은 회사에서 만든 Marker(PDF to Markdown 변환 도구)와 Surya(OCR 모델)의 후속작입니다.
- Markdown, HTML, JSON으로 변환 (레이아웃 정보 포함)
- 손글씨 지원
- 폼, 체크박스 정확하게 재구성
- 표, 수식, 복잡한 레이아웃 지원
- 이미지/다이어그램 추출 (캡션 포함)
- 40개 이상 언어 지원
- 두 가지 추론 모드: Local (HuggingFace), Remote (vLLM)
벤치마크 성능
olmocr bench 기준으로 Chandra는 83.1점으로 1위를 기록했습니다. 특히 Tables(88.0), Old Scans Math(80.3), Long tiny text(92.3) 항목에서 최고 점수를 받았습니다.
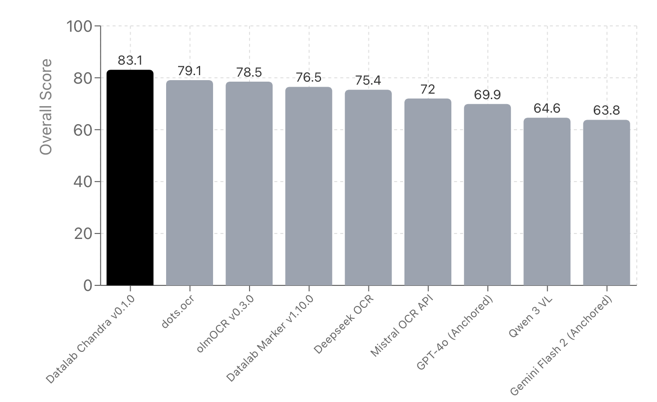
| Model | ArXiv | Old Scans Math | Tables | Old Scans | Headers/ Footers |
Multi column |
Long tiny text |
Base | Overall |
|---|---|---|---|---|---|---|---|---|---|
| Datalab Chandra v0.1.0 | 82.2 | 80.3 | 88.0 | 50.4 | 90.8 | 81.2 | 92.3 | 99.9 | 83.1 |
| dots.ocr | 82.1 | 64.2 | 88.3 | 40.9 | 94.1 | 82.4 | 81.2 | 99.5 | 79.1 |
| olmOCR v0.3.0 | 78.6 | 79.9 | 72.9 | 43.9 | 95.1 | 77.3 | 81.2 | 98.9 | 78.5 |
| Datalab Marker v1.10.0 | 83.8 | 69.7 | 74.8 | 32.3 | 86.6 | 79.4 | 85.7 | 99.6 | 76.5 |
| Deepseek OCR | 75.2 | 72.3 | 79.7 | 33.3 | 96.1 | 66.7 | 80.1 | 99.7 | 75.4 |
| Mistral OCR API | 77.2 | 67.5 | 60.6 | 29.3 | 93.6 | 71.3 | 77.1 | 99.4 | 72.0 |
| GPT-4o (Anchored) | 53.5 | 74.5 | 70.0 | 40.7 | 93.8 | 69.3 | 60.6 | 96.8 | 69.9 |
| Qwen 3 VL 8B | 70.2 | 75.1 | 45.6 | 37.5 | 89.1 | 62.1 | 43.0 | 94.3 | 64.6 |
| Gemini Flash 2 (Anchored) | 54.5 | 56.1 | 72.1 | 34.2 | 64.7 | 61.5 | 71.5 | 95.6 | 63.8 |
로컬 실행 시도
먼저 Google Colab에서 로컬 실행을 시도해 봤습니다.
# 설치
pip install chandra-ocr
pip install flash-attn --no-build-isolation

# 실행
chandra input.jpg ./output --method hf
모델 크기가 약 17GB라서 다운로드에 시간이 걸렸고, 막상 실행하니 CUDA 메모리 부족 에러가 발생했습니다. Colab 무료 버전의 T4 GPU(15GB)로는 부족했습니다. 로컬에서 실행하려면 최소 24GB 이상의 GPU 메모리가 필요해 보입니다.
Playground 테스트
다행히 Datalab에서 무료 Playground를 제공합니다. 로그인 없이 10페이지까지 테스트할 수 있습니다.
https://www.datalab.to/playground/documents/new
www.datalab.to
모드 선택
Playground에서는 세 가지 모드를 선택할 수 있습니다.
| 모드 | 설명 | 용도 |
|---|---|---|
| Fast | 가장 낮은 지연 시간 | 실시간 처리 |
| Balanced | 정확도와 지연 시간의 균형 | 대부분의 문서 |
| Accurate | 가장 높은 정확도 | 복잡한 문서 |
추가 기능
로그인 후 카드를 등록하면 $5 크레딧과 함께 추가 기능을 사용할 수 있습니다.
- Track Changes (DOCX): MS Word의 변경 내용 추적 및 주석을 Markdown/HTML로 변환. 법률 검토 워크플로우에 유용
- Chart Understand: 차트/그래프 데이터를 HTML 테이블로 변환. 투자 보고서나 컨설팅 문서에 유용
- Segmentation: 문서 영역 분할
- Extract: 특정 데이터 추출
테스트 결과
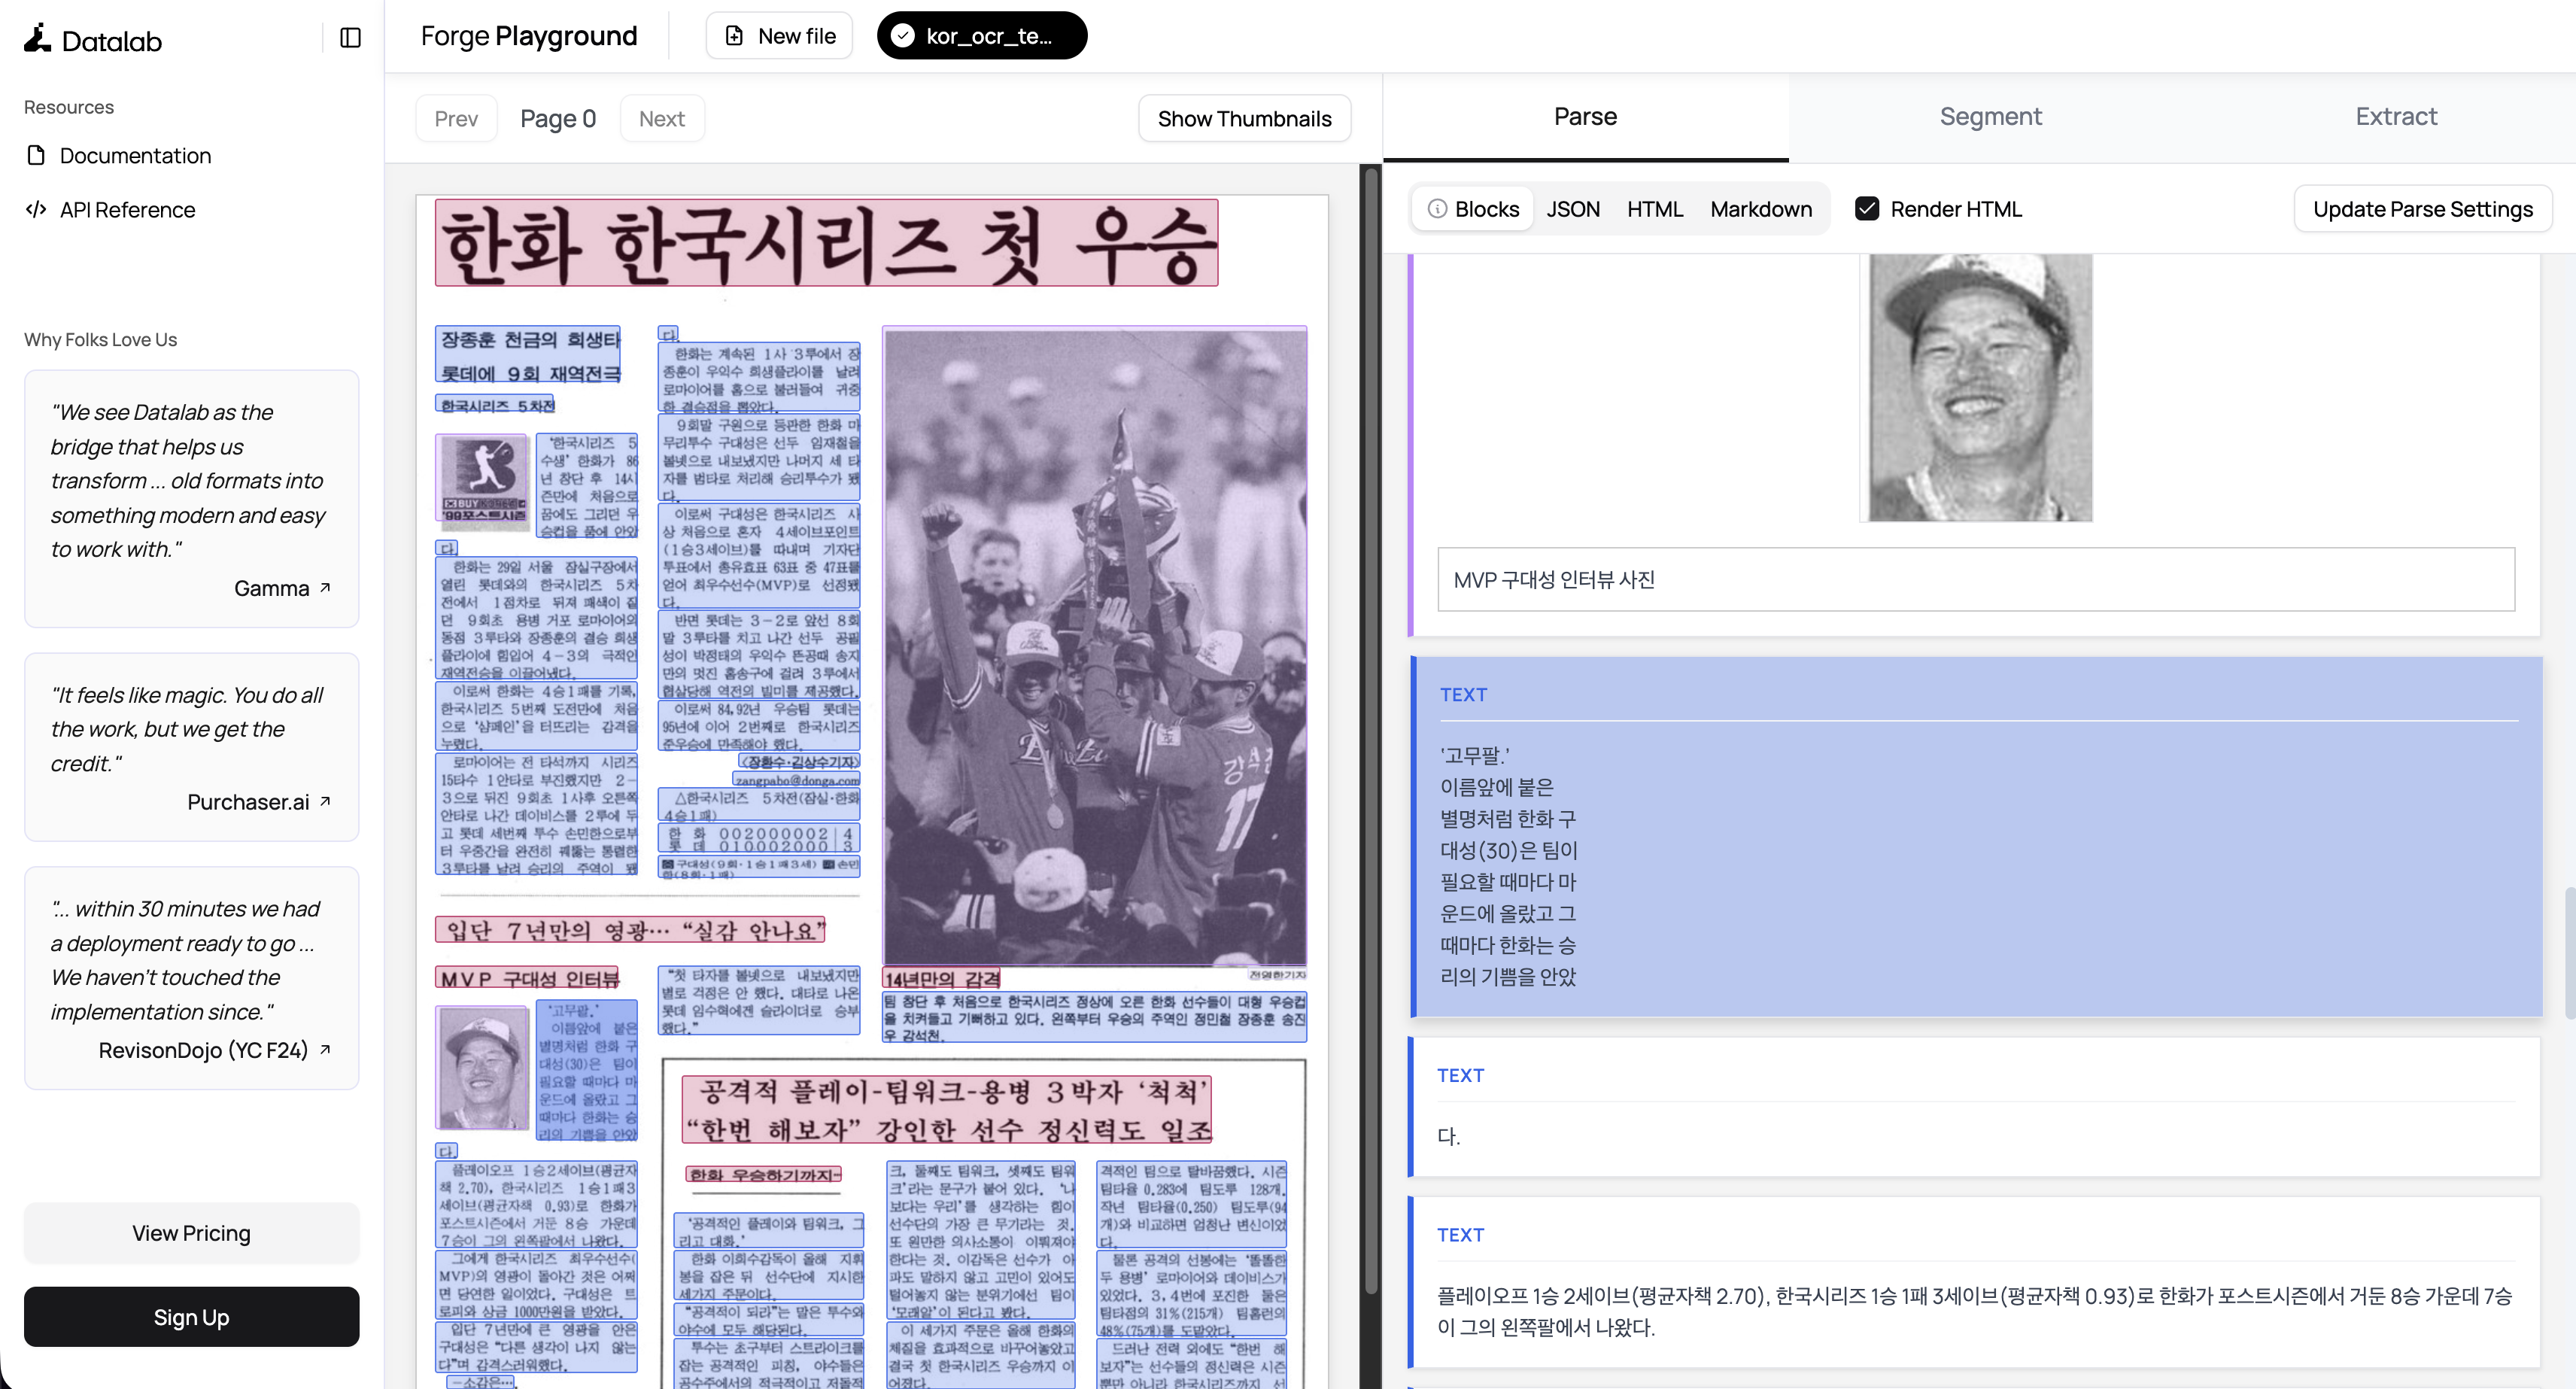
한글 문서로 테스트해 봤습니다.
테스트 이미지 1
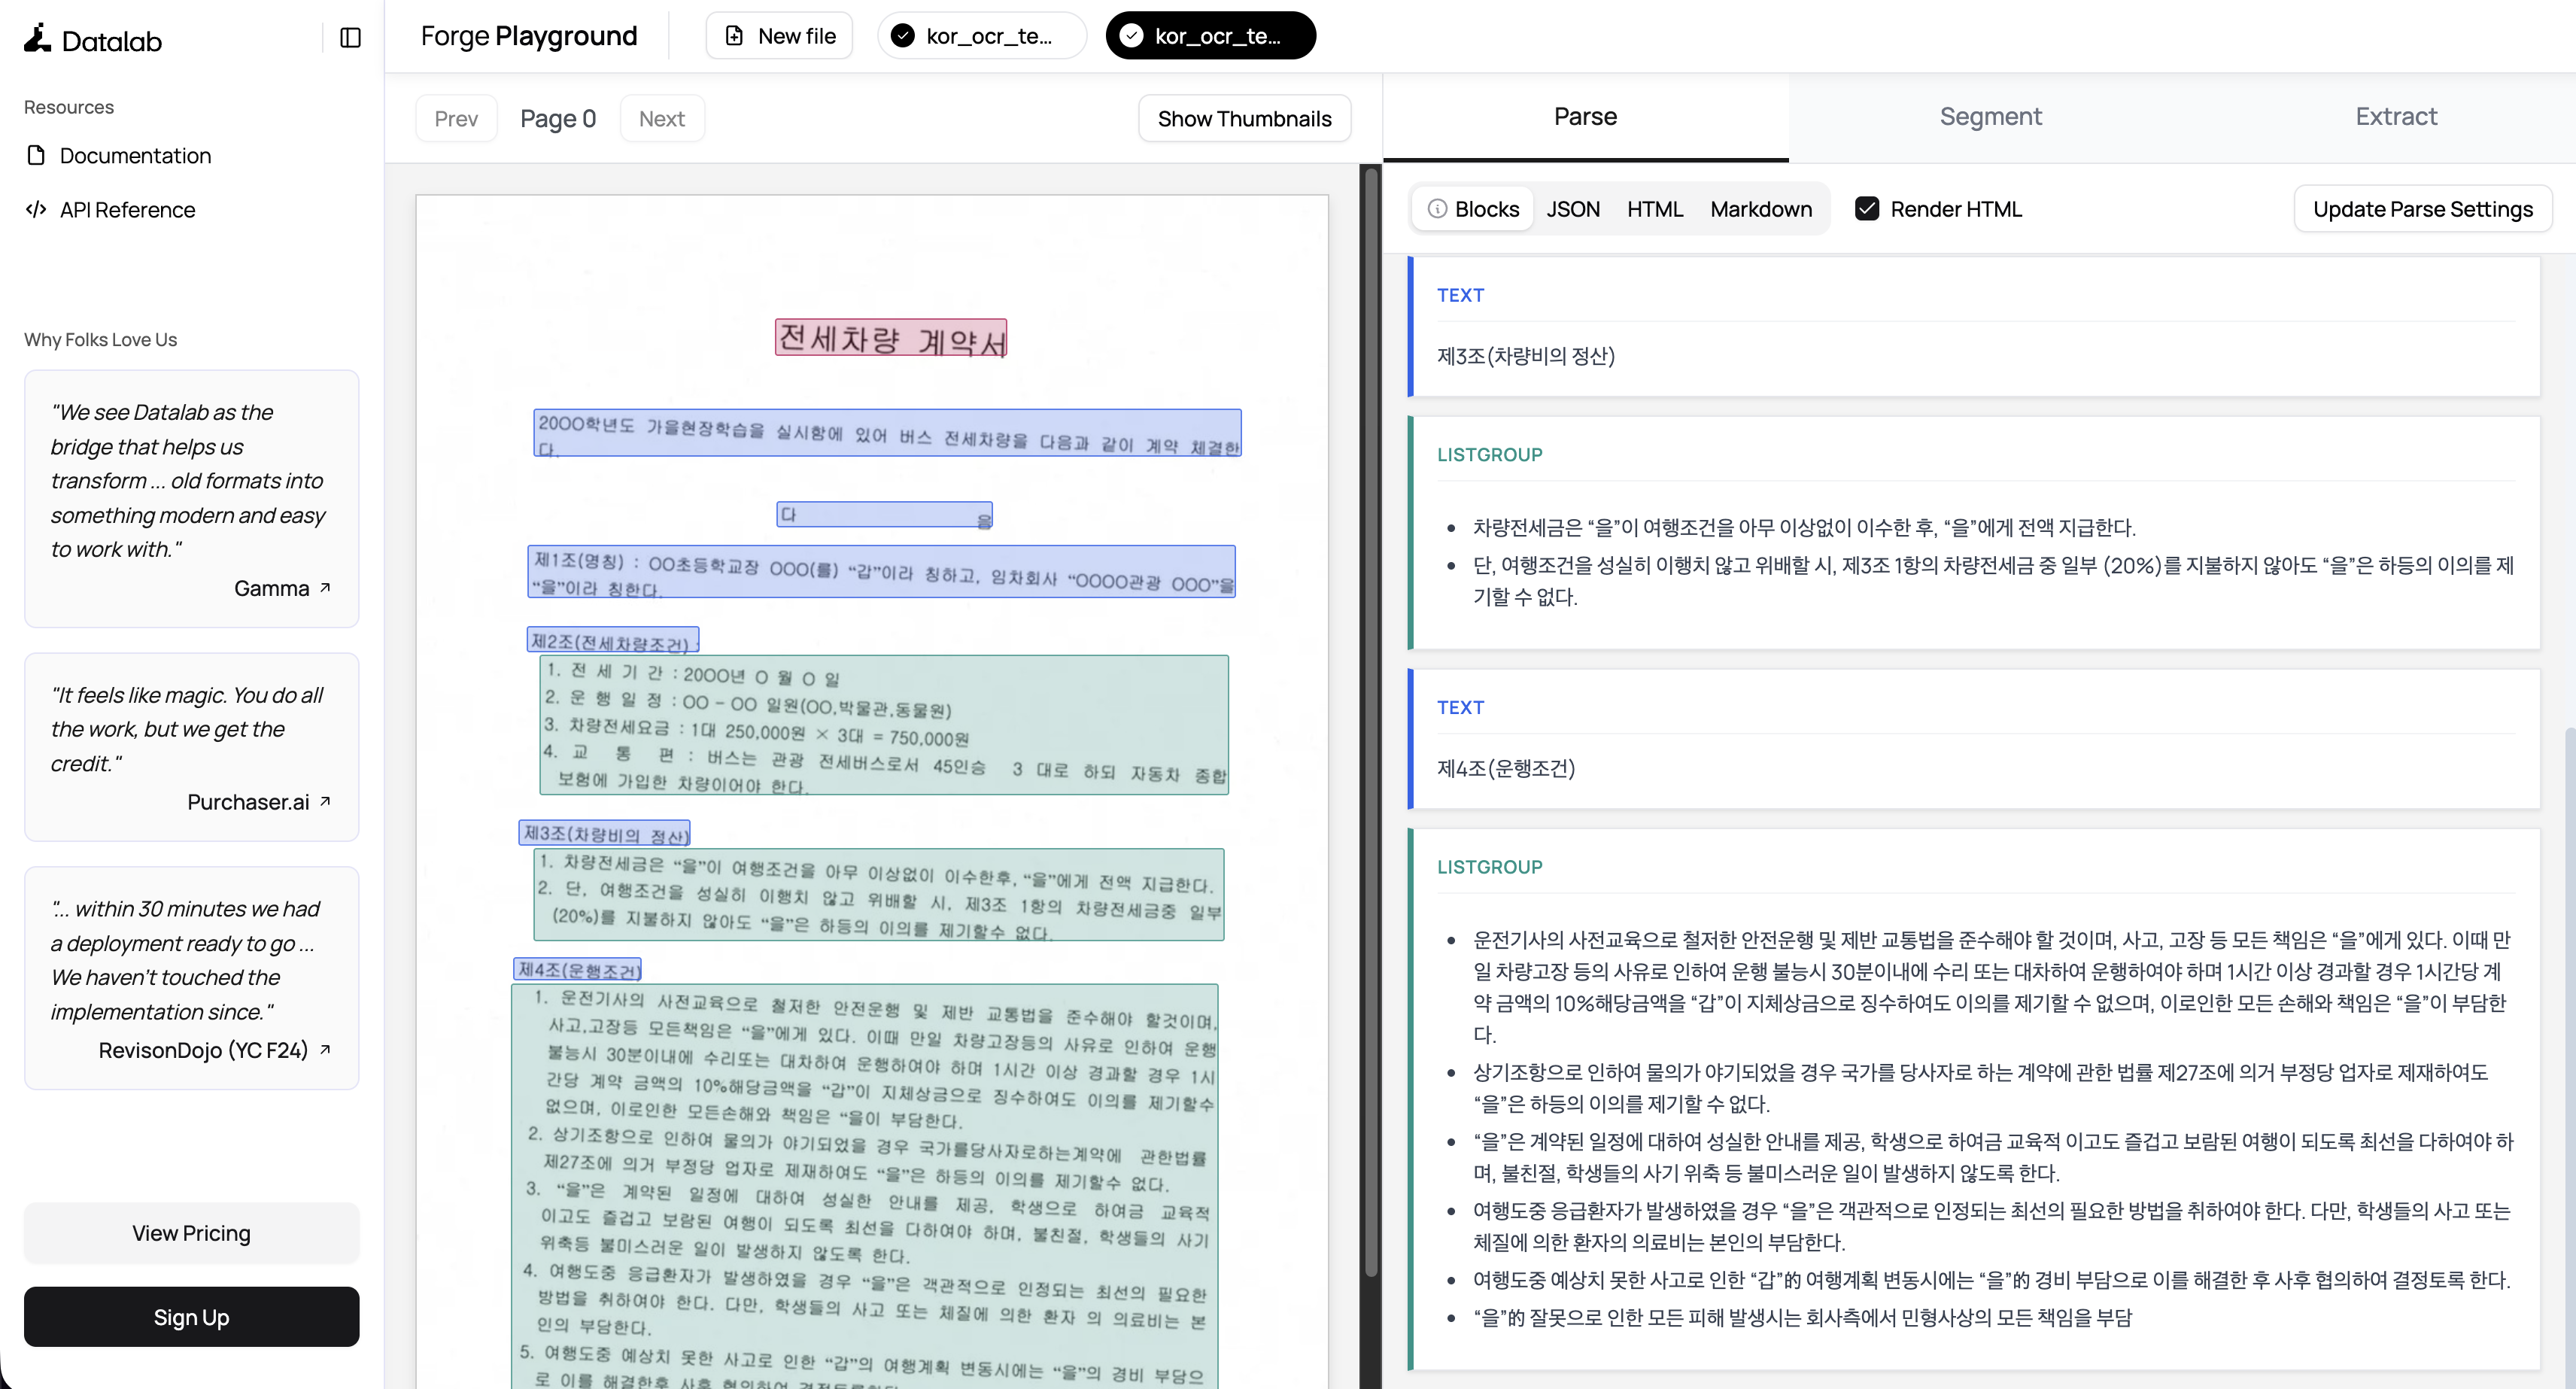
테스트 이미지 2
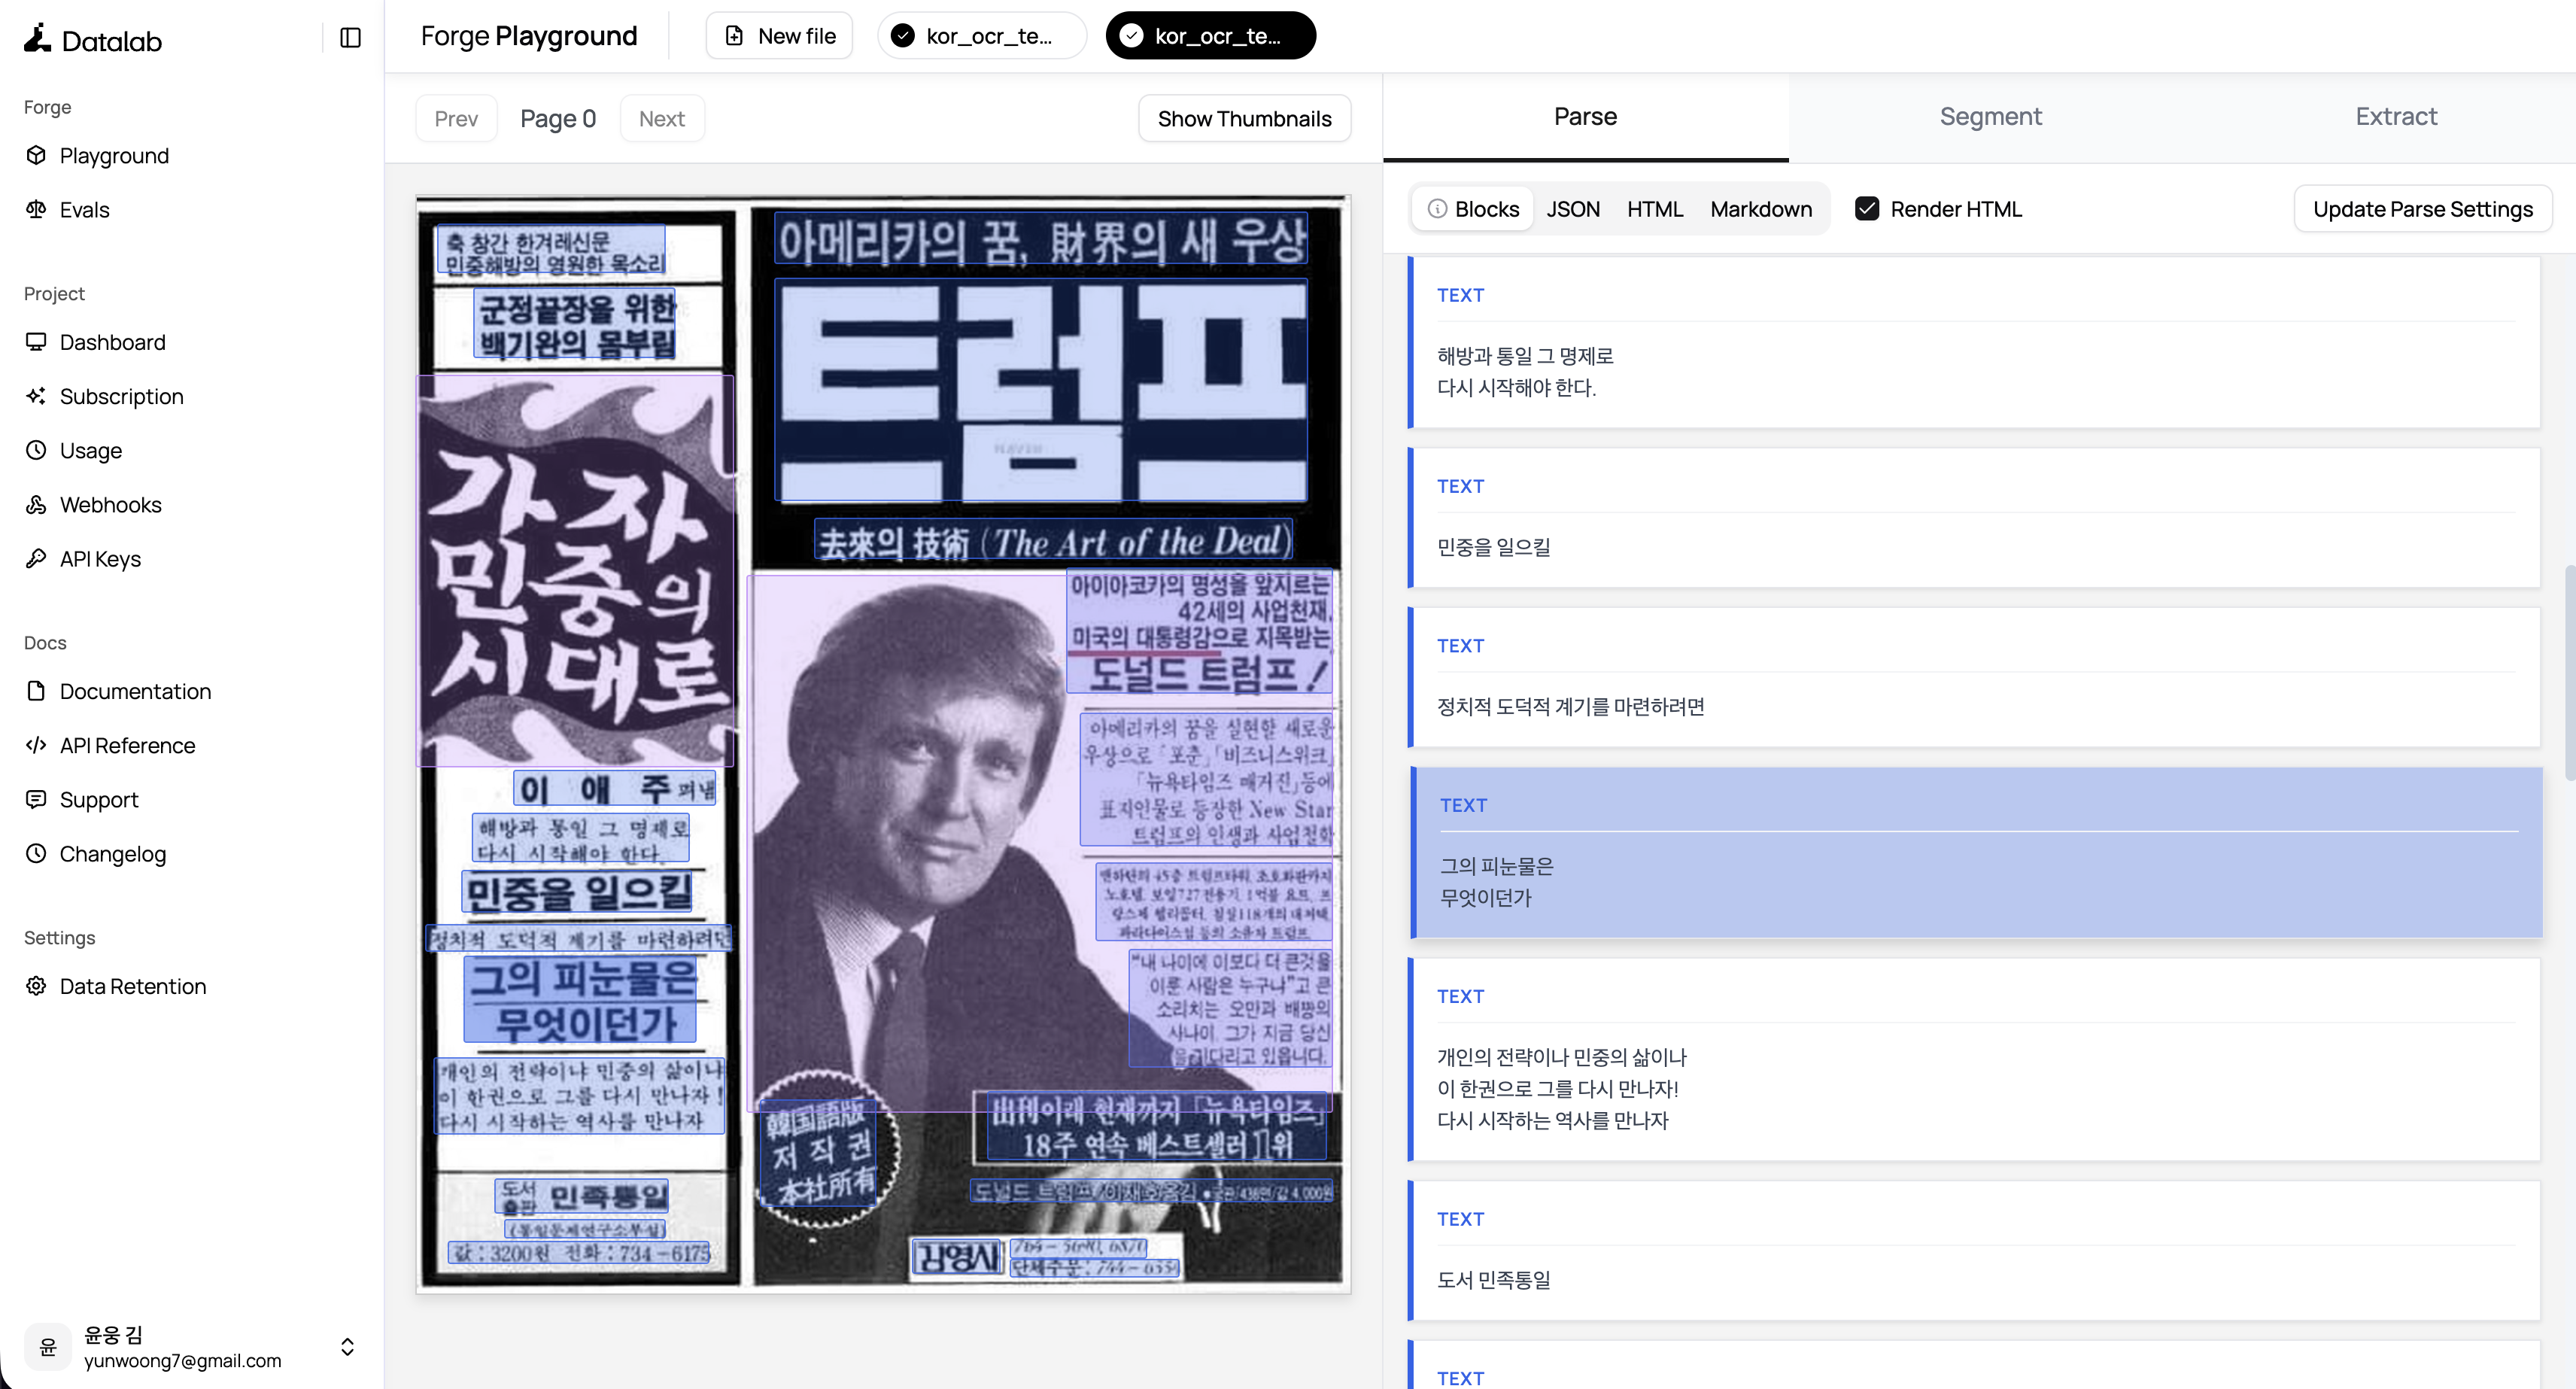
테스트 이미지 3
속도
속도는 생각보다 빠르지 않았습니다. 이미지 한 장당 약 15초에서 1분 정도 걸렸습니다. Fast 모드라고 해서 확연히 빠른 것은 아니었고, 오히려 Fast가 Balanced보다 늦게 나온 적도 있었습니다. 서버 상태에 따라 달라지는 것 같습니다.
인식 품질
OCR 성능 자체는 매우 뛰어났습니다. 한글 인식도 잘 되었고, 테이블 구조도 정확하게 파악했습니다. 특히 복잡한 레이아웃의 문서에서 좋은 결과를 보여줬습니다.
로컬 설치 및 CLI 사용법
GPU 메모리가 충분하다면 로컬에서도 실행할 수 있습니다.
설치
# 설치
pip install chandra-ocr

# flash attention 설치 (권장)
pip install flash-attn --no-build-isolation
CLI 사용법
# HuggingFace 방식 (로컬 모델)
chandra input.pdf ./output --method hf

# vLLM 서버 방식
chandra input.pdf ./output --method vllm

# 디렉토리 전체 처리
chandra ./documents ./output --method hf

# 페이지 범위 지정 (PDF)
chandra input.pdf ./output --page-range "1-5,7,9-12"

# 이미지 추출 제외
chandra input.pdf ./output --no-images
vLLM 서버 실행
배치 처리나 프로덕션 환경에서는 vLLM 서버를 사용하는 것이 좋습니다.
# vLLM 서버 실행 (Docker)
chandra_vllm

# 환경 변수 설정
export VLLM_API_BASE=http://localhost:8000/v1
export VLLM_MODEL_NAME=chandra
export VLLM_GPUS=0
라이선스
Chandra의 라이선스는 두 가지로 나뉩니다.
- 코드: Apache 2.0
- 모델 가중치: OpenRAIL-M 수정 버전
- 연구, 개인 용도: 무료
- 펀딩/매출 $2M 이하 스타트업: 무료
- API와 경쟁적 사용: 불가
- 그 외 상업적 사용: 별도 라이선스 필요
결론
Chandra는 현재 벤치마크 기준으로 가장 뛰어난 OCR 모델 중 하나입니다. 특히 테이블, 수식, 복잡한 레이아웃 처리에서 강점을 보입니다. 한글 인식도 잘 됩니다.
다만 몇 가지 고려할 점이 있습니다.
- 리소스 요구량: 로컬 실행 시 약 17GB 모델 다운로드, 24GB 이상 GPU 메모리 필요
- 속도: Playground 기준 장당 15초~1분. 실시간 처리에는 부적합
- 라이선스: 상업적 사용 시 라이선스 확인 필요
참고 링크
- Chandra GitHub
- Chandra Playground - 무료 테스트 (10페이지)
- Datalab 공식 사이트
'Tech & Development > OCR' 카테고리의 다른 글
| [ OCR ] PaddleOCR 3.0 - PP-OCRv5, PaddleOCR-VL 한글 인식 테스트 (0) | 2025.12.31 |
|---|---|
| [ OCR ] 한글 인식에 탁월한 성능, 적은 용량의 PaddleOCR 사용하기 - Python (3) | 2023.07.05 |
| [ OCR ] kakaobrain pororo OCR 사용하기 - Python (7) | 2023.02.06 |
| [ OCR ] Naver CLOVA OCR API 를 이용한 OCR 개발 - Python (2) | 2022.05.06 |
| [ OCR ] Amazon Rekognition API 를 이용한 OCR 개발 - Python (0) | 2022.05.06 |