[ OCR ] PaddleOCR 3.0 - PP-OCRv5, PaddleOCR-VL 한글 인식 테스트
2023년에 PaddleOCR을 소개한 적이 있습니다. 당시 PP-OCRv3 기준으로 한글 인식 성능이 꽤 괜찮았는데, 2025년 10월에 PaddleOCR 3.0이 출시되면서 많은 변화가 있었습니다. 이번 글에서는 새로운 라인업인 PP-OCRv5, PP-StructureV3, PaddleOCR-VL을 테스트해본 결과를 공유합니다.
GitHub - PaddlePaddle/PaddleOCR: Turn any PDF or image document into structured data for your AI. A powerful, lightweight OCR to
Turn any PDF or image document into structured data for your AI. A powerful, lightweight OCR toolkit that bridges the gap between images/PDFs and LLMs. Supports 100+ languages. - PaddlePaddle/Paddl...
github.com
PaddleOCR 3.0 주요 변경점
PaddleOCR 3.0은 기존 PP-OCRv3에서 상당히 발전했습니다.
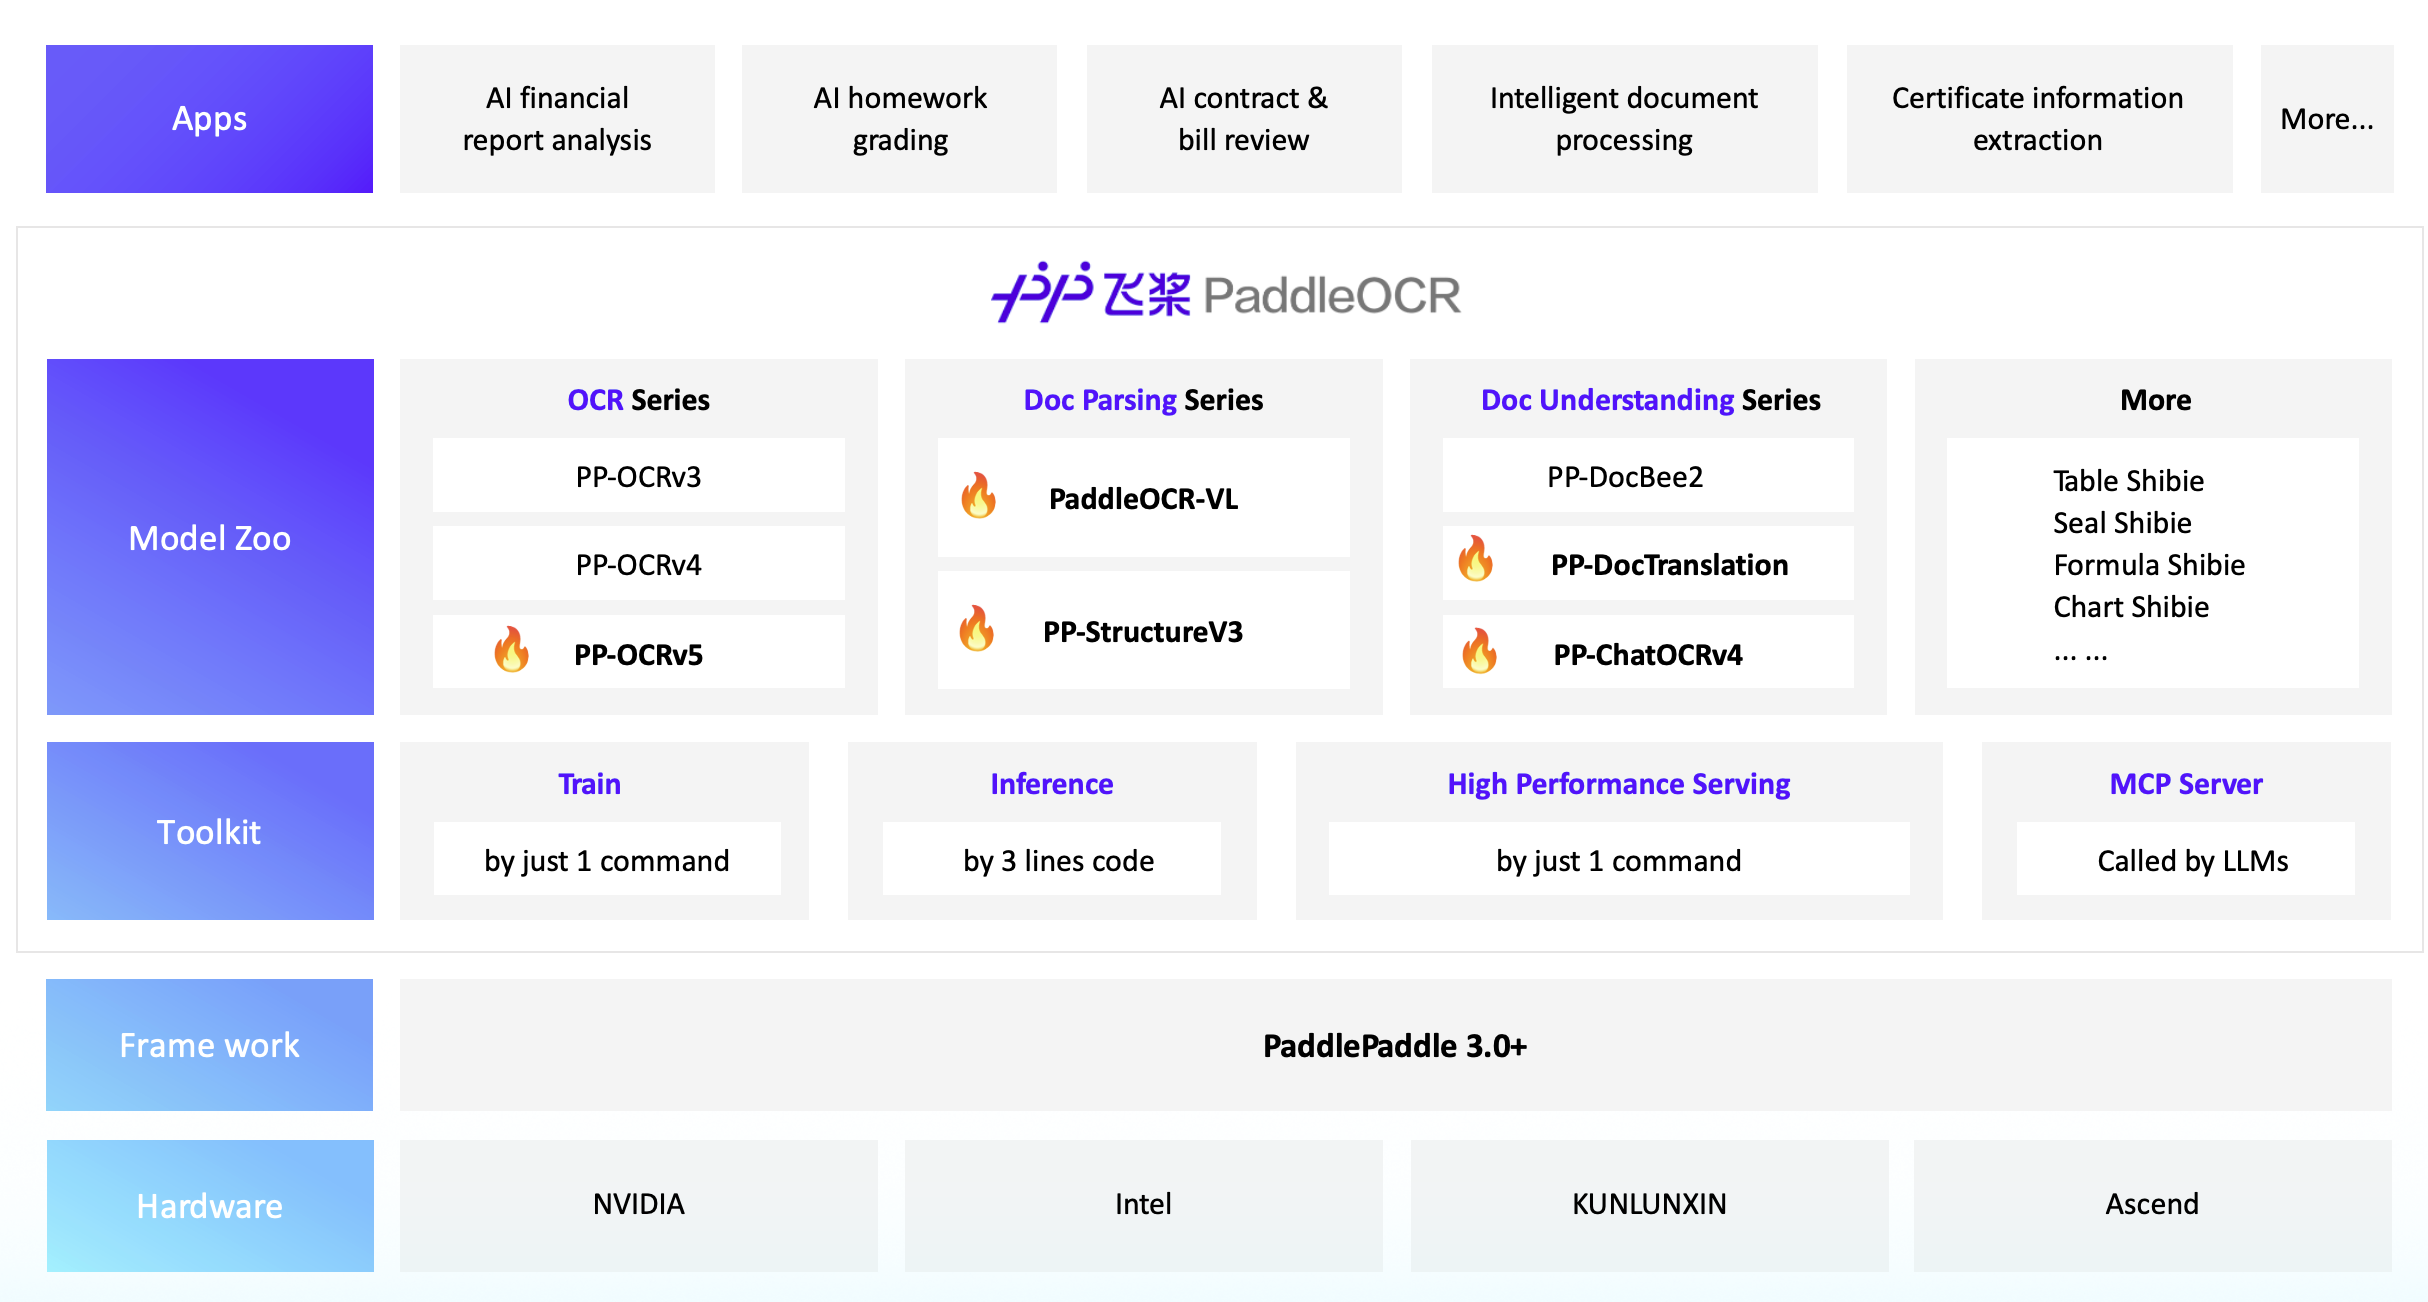
| 기능 | 설명 | 용도 |
|---|---|---|
| PP-OCRv5 | 109개 언어 지원, 단일 모델로 다국어 인식 | 일반 텍스트 인식 |
| PP-StructureV3 | 문서 레이아웃 분석, 테이블 인식, Markdown 변환 | 문서 구조 분석 |
| PaddleOCR-VL | 0.9B VLM 기반 문서 파싱 | 복잡한 문서 이해 |
설치
설치 방법이 기존과 조금 다릅니다. CUDA 버전에 맞는 PaddlePaddle을 설치해야 합니다. (CPU버전을 설치하여 테스트 해도 됩니다)
# CUDA 버전 확인
nvcc --version

# GPU 버전 (CUDA 12.x 기준)
pip install paddlepaddle-gpu -i https://www.paddlepaddle.org.cn/packages/stable/cu126/pip install "paddleocr[all]"

# CPU 버전
# pip install paddlepaddle
# pip install "paddleocr[all]"
PP-OCRv5 - 텍스트 인식
PP-OCRv5는 기존 PP-OCRv3의 후속 모델입니다. 가장 큰 변화는 단일 모델로 109개 언어를 지원한다는 점입니다. 모델 크기는 2M으로 경량화되었고, 이전 버전 대비 정확도가 13% 향상되었다고 합니다.
사용법
from paddleocr import PaddleOCR

ocr = PaddleOCR(
    lang="korean",
    use_doc_orientation_classify=False,
    use_doc_unwarping=False,
    use_textline_orientation=False
)

result = ocr.predict(input="test_image.jpg")

for res in result:
    res.print()
    res.save_to_img("output")
    res.save_to_json("output")
설명에는 언어 지정 없이도 다국어를 자동으로 인식한다고 되어 있지만 lang="korean" 을 지정하지 않으니 한글인식이 잘 되지 않아서 지정해야 합니다.
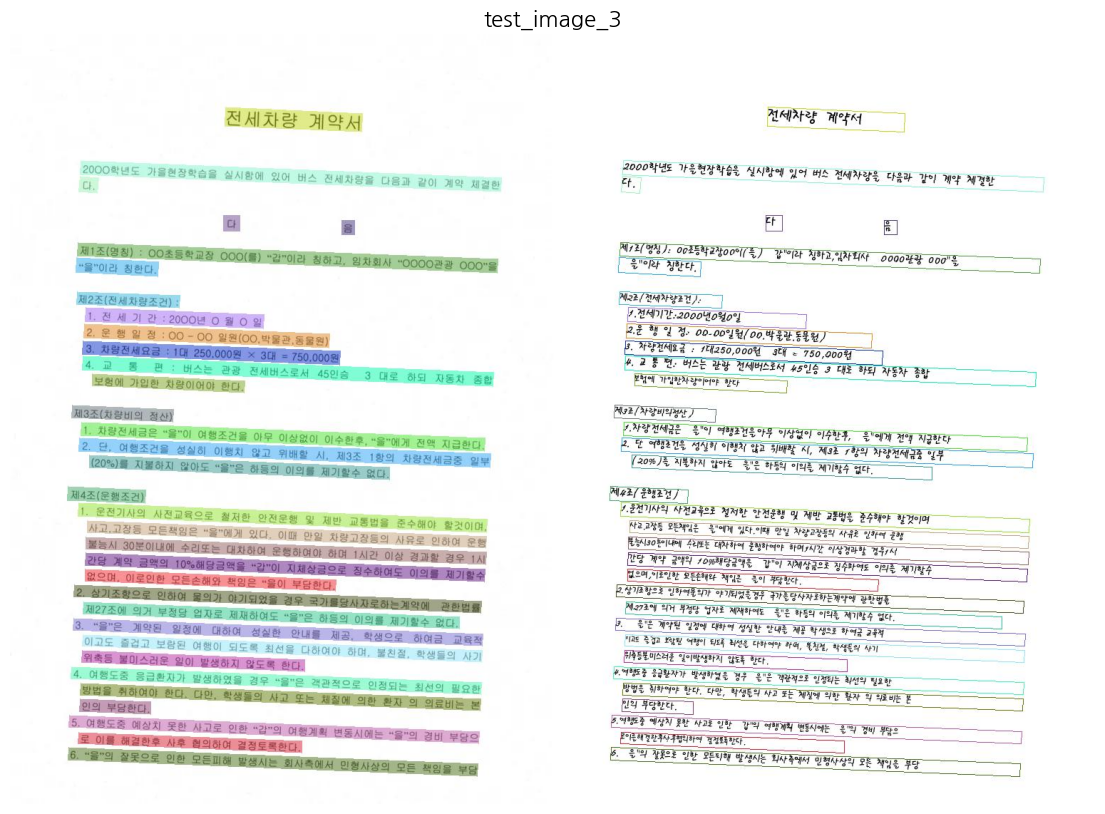
테스트 결과
전체적으로 양호한 결과를 보여줬습니다. 속도도 빠르고, 일부 오인식이 있었지만 전반적으로 괜찮았습니다. 기존 PP-OCRv3와 비교했을 때 체감상 큰 차이는 느끼지 못했지만, 다국어 혼합 문서에서는 확실히 편해졌습니다.
PP-StructureV3 - 문서 구조 분석
PP-StructureV3는 문서의 레이아웃을 분석하고 구조화된 데이터로 변환합니다. 텍스트, 표, 이미지, 수식 등 영역을 구분하고, Markdown이나 JSON 형식으로 변환할 수 있습니다.
사용법
from paddleocr import PPStructureV3

structure = PPStructureV3(
    lang="korean",
    use_doc_orientation_classify=False,
    use_doc_unwarping=False
)

result = structure.predict(input="test_image.jpg")

for res in result:
    res.print()
    res.save_to_img("output")
    res.save_to_json("output")
    res.save_to_markdown("output")
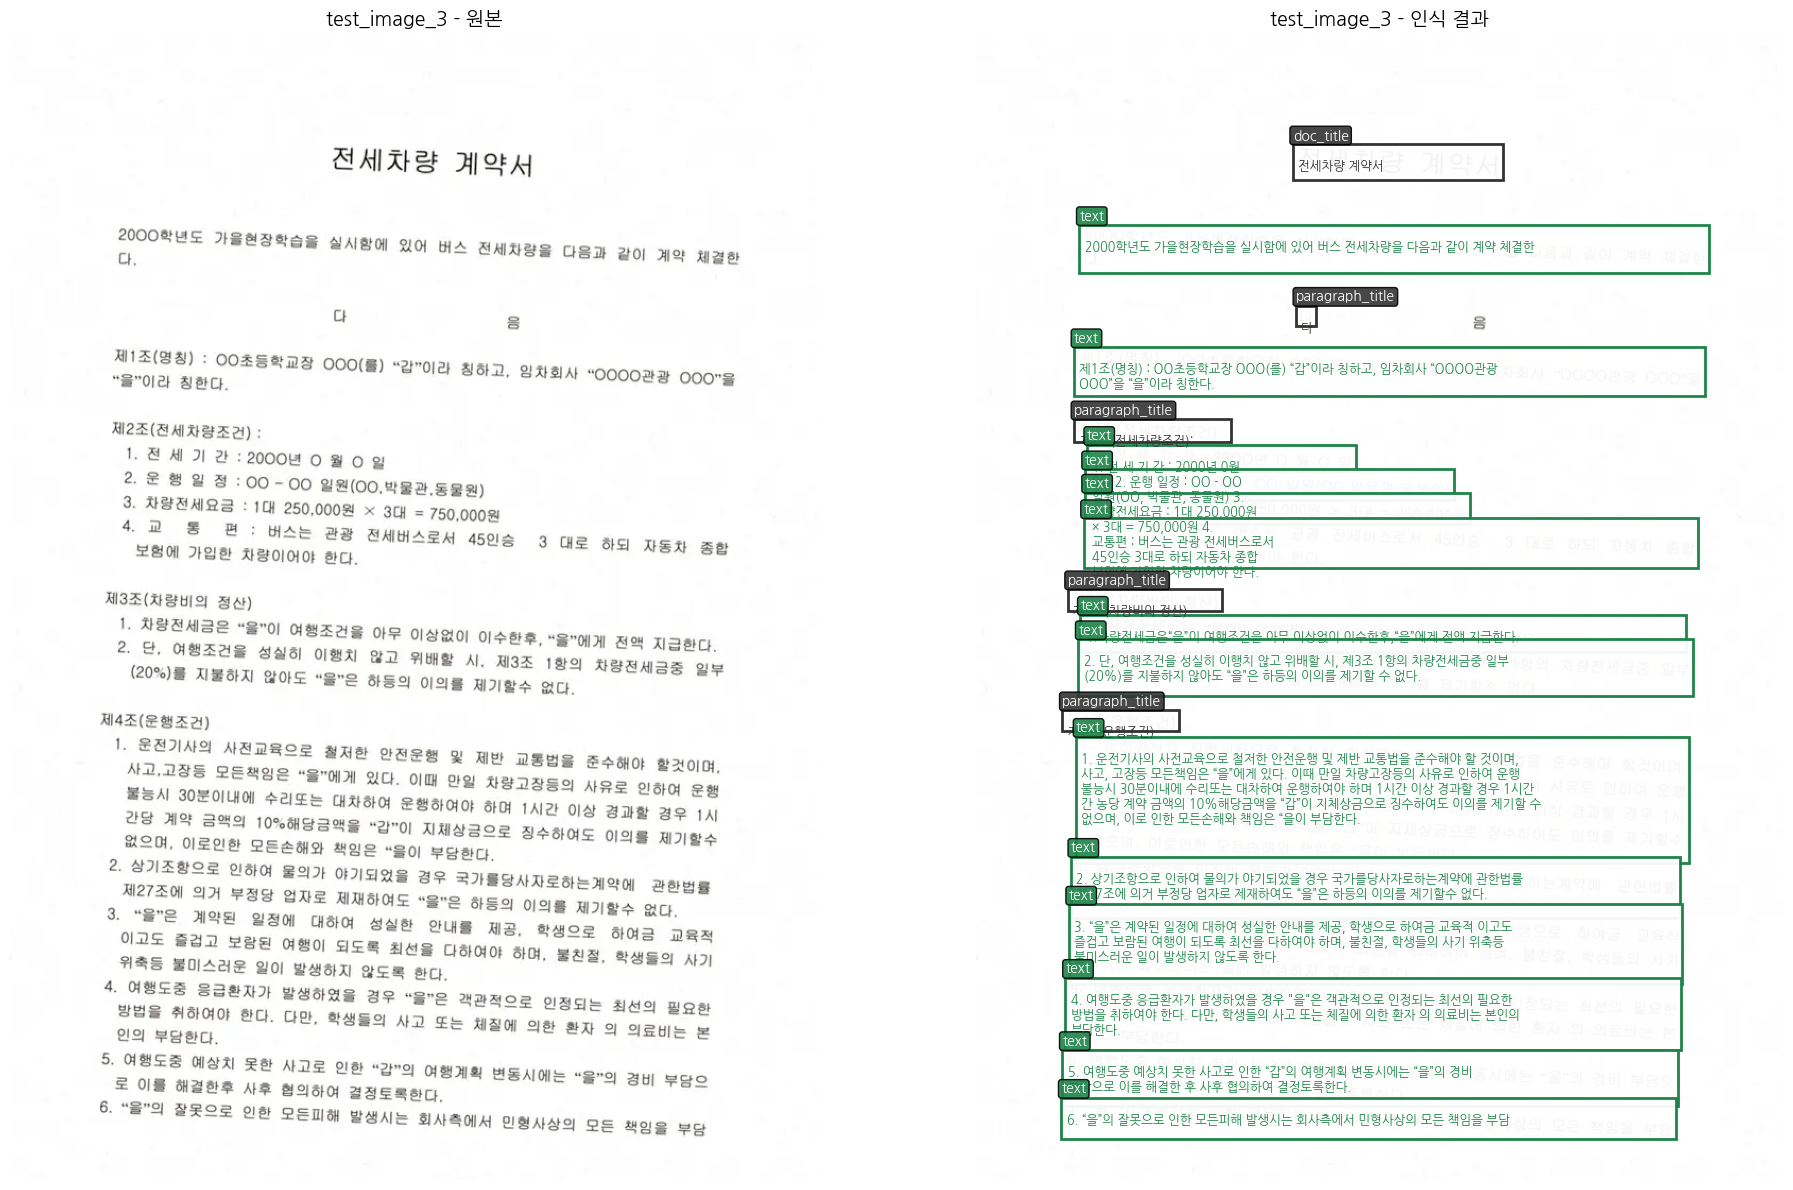
테스트 결과
솔직히 한글 문서에서는 결과가 좋지 않았습니다. 레이아웃 분석은 되는데 텍스트 인식 정확도가 떨어졌습니다. 영어나 중국어 문서에서는 잘 동작할 수 있지만, 한글 문서에는 PP-OCRv5나 PaddleOCR-VL을 사용하는 게 나을 것 같습니다.

PaddleOCR-VL - VLM 기반 문서 파싱
PaddleOCR-VL은 0.9B 파라미터의 Vision-Language Model을 기반으로 한 문서 파싱 모델입니다. 기존 파이프라인 방식(감지 → 인식)과 달리 End-to-End로 문서를 이해합니다.
주요 특징
- 0.9B 경량 VLM으로 비교적 빠른 추론
- 109개 언어 자동 인식 (별도 언어 설정 불필요)
- header, table, text 등 영역 자동 구분
- 테이블을 HTML 형식으로 변환
- 손글씨, 역사 문서 등 다양한 문서 타입 지원
사용법
from paddleocr import PaddleOCRVL

ocr_vl = PaddleOCRVL()  # lang 파라미터 없음

result = ocr_vl.predict(input="test_image.jpg")

for res in result:
    res.print()
    res.save_to_img("output")
    res.save_to_json("output")
    res.save_to_markdown("output")
PP-OCRv5와 달리 lang 파라미터가 없습니다. VLM이 자동으로 언어를 인식합니다.
테스트 결과
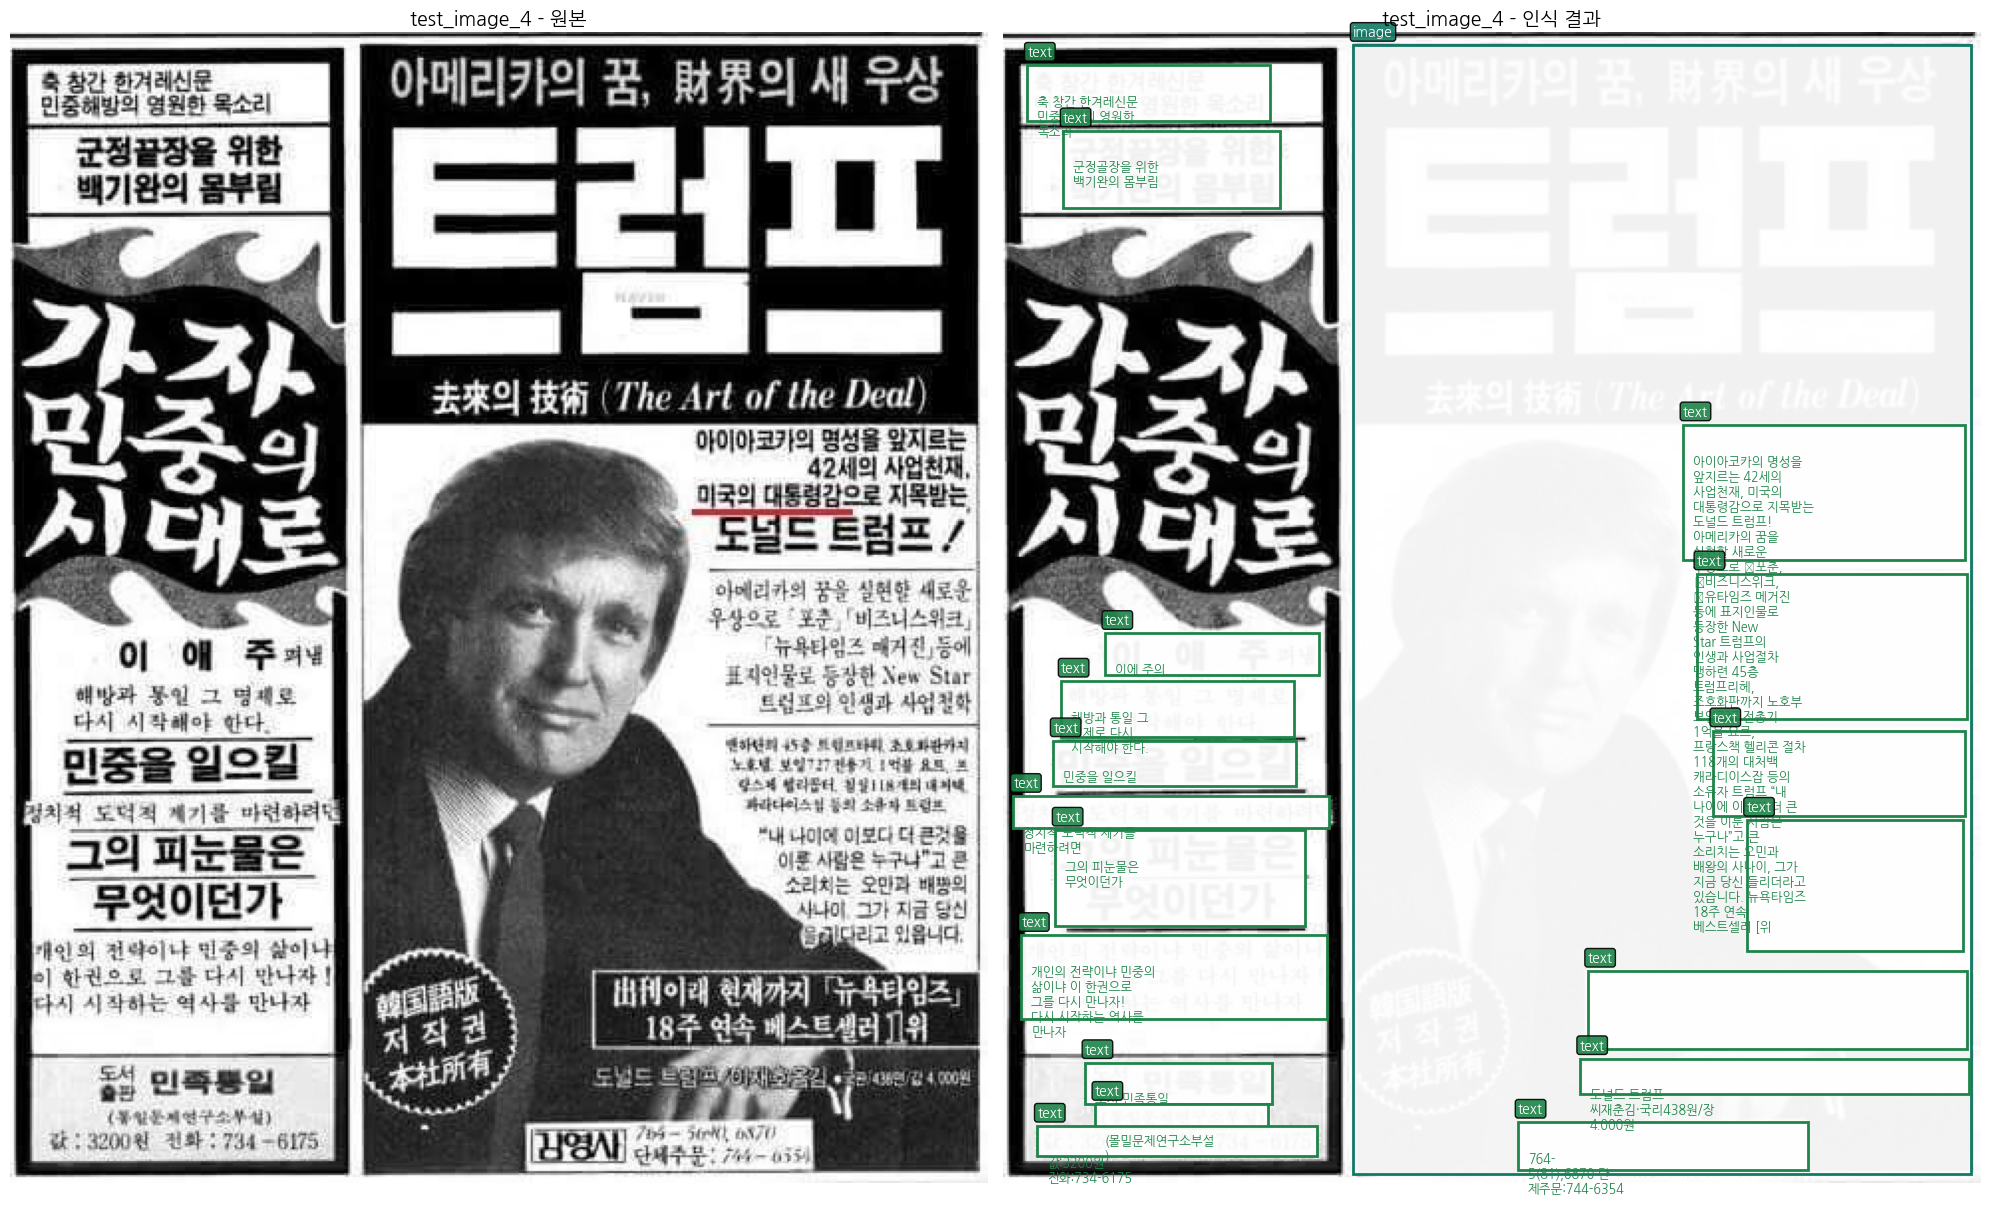
결과는 꽤 인상적이었습니다. header, table, text 등이 자동으로 구분되어 나오고, 다국어 인식도 잘 되었습니다. 테이블은 HTML 형식으로 변환되어 구조가 그대로 유지됩니다.
다만 속도가 문제입니다. CPU로 돌리면 이미지 한 장당 약 10분 정도 걸렸습니다. GPU 환경에서 사용하는 것을 권장합니다. 일부 복잡한 이미지에서 누락이 있었지만, 일반적인 문서에서는 매우 뛰어난 성능을 보여줬습니다.
결론
PaddleOCR 3.0은 용도에 따라 세 가지 모델을 선택할 수 있게 되었습니다.
- 단순 텍스트 추출: PP-OCRv5 - 빠르고 가볍습니다
- 문서 구조가 중요한 경우: PaddleOCR-VL - GPU 환경에서 사용하세요
- PP-StructureV3: 한글 문서에서는 아직 추천하기 어렵습니다
개인적으로는 일반적인 OCR 작업에는 PP-OCRv5, 테이블이 포함된 복잡한 문서에는 PaddleOCR-VL을 사용할 것 같습니다. GPU 환경만 갖춰진다면 PaddleOCR-VL의 결과물이 가장 만족스러웠습니다.
전체 테스트 코드는 Colab 노트북으로 공유합니다.
'Tech & Development > OCR' 카테고리의 다른 글
| [ OCR ] Chandra OCR - 한글 테스트 (0) | 2026.01.01 |
|---|---|
| [ OCR ] 한글 인식에 탁월한 성능, 적은 용량의 PaddleOCR 사용하기 - Python (3) | 2023.07.05 |
| [ OCR ] kakaobrain pororo OCR 사용하기 - Python (7) | 2023.02.06 |
| [ OCR ] Naver CLOVA OCR API 를 이용한 OCR 개발 - Python (2) | 2022.05.06 |
| [ OCR ] Amazon Rekognition API 를 이용한 OCR 개발 - Python (0) | 2022.05.06 |